
采样、走样与滤波
采样、走样与滤波
1. 一切都是采样
采样(sampling)就是"在连续的东西上,隔一段取一个值"。
图形管线里到处都是采样:
| 什么在被采样 | 采样点是什么 |
|---|---|
| 一个连续的三维场景 | 每个像素的中心 |
| 一张图像 | 每取一次样的位置 |
| 一段连续的运动 | 每一帧(时间上的采样) |
| 一张大图缩小成小图 | 小图的每个像素 |
采样必然丢信息——你只留下了有限个数,中间发生了什么无从得知。上一篇讲的插值,是在"猜"丢掉的那部分。这一篇讲的是:丢得太多的时候,会发生比"糊"严重得多的事。
2. 走样:信号伪装成了别的东西
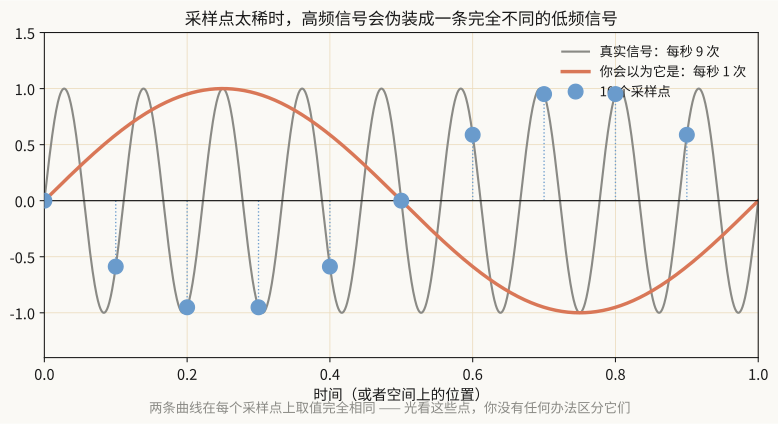
图:灰色细线是真实信号,每秒振荡 9 次。蓝点是 10 个采样点。橙色粗线是每秒振荡 1 次的另一条信号——它在每一个采样点上的取值,和真实信号完全相同。
光看这 10 个点,你没有任何办法区分这两条信号。 高频信号"伪装"成了一条低频信号,这个现象叫走样(aliasing,也译混叠)。alias 本来就是"化名"的意思。
关键在于:走样造出来的低频,是原始信号里根本不存在的东西。 它不是"细节丢了",是"凭空多了假东西"——这比丢细节严重得多,因为你没法靠后处理去掉它(你分不清哪些是真的)。
生活里的例子:电影里高速旋转的车轮看起来在倒转,就是快门(时间采样)跟不上转速导致的走样。
3. 奈奎斯特:一句话版本
采样率要多高才不出事?答案叫奈奎斯特采样定理(Nyquist):
采样频率必须超过信号最高频率的两倍。
翻译成图像的话:若黑白条纹各宽 1 像素,它的一个周期是 2 像素;要在理想条件下表示这个周期,至少需要每个像素取一个样本,也就是每周期两个样本。若每 2 个像素才采一次,只会反复看到同一个相位,条纹会走样成一块常量。比 1 像素更细的花纹,则已经超出这张像素网格能稳定表达的范围。
反过来说,如果信号里含有超过一半采样率的频率成分,它们不会消失,而是会折叠回来变成假的低频。这就是上一节那张图的原理。
这条定理给了我们唯一的解法:既然高频注定要作乱,那就在采样之前先把高频去掉。去掉高频这件事叫低通滤波(low-pass filter),俗称"模糊"。
4. 摩尔纹:二维的走样
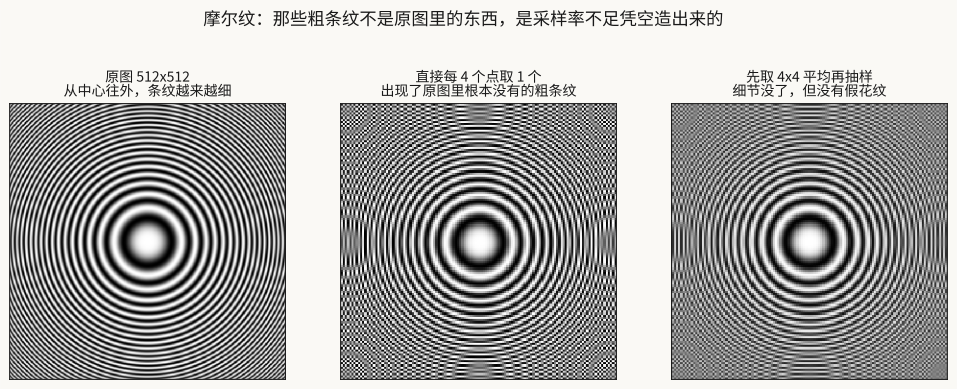
图:一张同心圆条纹图,越往外条纹越细。中间那格是直接每 4 个像素取 1 个——出现了大片原图里根本没有的粗条纹。右边那格先做 4×4 平均再抽样,虽然细节没了,但没有假花纹。
这些假花纹就是摩尔纹(moiré)。你在这些地方见过它:
- 拍摄电脑屏幕或格子衬衫的照片;
- 缩小一张细密的图像时,它糊成一片诡异的条纹;
- 远处的栅栏、瓦片屋顶在画面里闪烁。
中间那格和右边那格的差别,就是有没有做低通。 这是本篇的中心。
5. 卷积:一个滑动的加权和
"低通滤波"具体怎么做?答案是卷积(convolution)。
听起来吓人,其实上一篇已经讲过了它的核心思想:给每个像素,把它周围一圈邻居按一组固定的权重加起来。
( 就是"全部加起来",不认识翻速查表。)
那组权重排成方阵,就叫卷积核(kernel)。上一篇讲的三角核、三次核是一维的版本,这里是二维的。
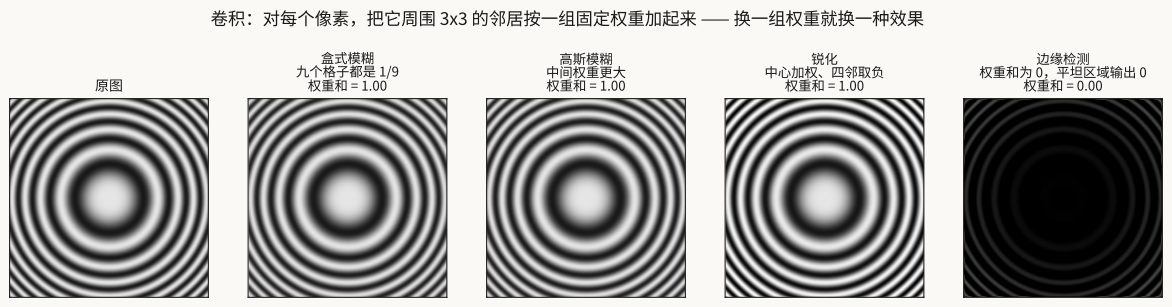
跟着算一次。取 3×3 的盒式模糊核,九个格子都是 :
假设某个像素周围 9 个值分别是 ,那么
中心那个 0.9 被周围的小值拉了下来——这就是"模糊"在数值上的样子。
从权重和看核在干什么
| 核 | 权重和 | 效果 |
|---|---|---|
| 盒式模糊 | 1 | 平均,整体亮度不变 |
| 高斯模糊 | 1 | 平均但中间权重更高,比盒式自然 |
| 锐化 | 1 | 中心加权、四邻取负,放大局部反差 |
| 边缘检测 | 0 | 平坦区域输出 0(全黑),只有变化处才有值 |
权重和是个很好用的速查指标:和为 1 的核不改变整体亮度;和为 0 的核会把平坦区域压成黑色,说明它在提取"变化"而不是"内容"。
6. 频域:把话说得更准
上面这些用"模糊""锐化""细节"来描述,够用但不精确。有一套更准的语言,值得花十分钟建立直觉。
任何图像都可以看成一堆不同频率的波叠加起来。
- 低频 = 大块的色调、整体的明暗;
- 高频 = 边缘、图像里的细小细节、噪点。
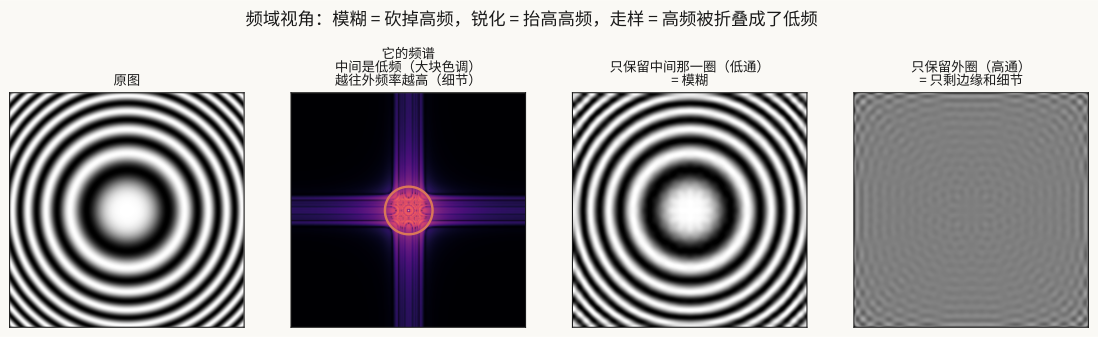
图:第二格是原图的频谱——中间是低频,越往外频率越高,亮度表示这个频率的成分有多强。第三格只保留中间那一圈(低通),得到的就是模糊图。第四格只保留外圈(高通),只剩下边缘。
有了这套词汇,前面所有结论都能重说一遍,而且更准:
| 之前的说法 | 频域的说法 |
|---|---|
| 模糊 | 低通滤波:砍掉高频 |
| 锐化 | 提升高频:把高频成分乘个大于 1 的系数再加回去 |
| 双线性放大会糊(第 6 篇) | 三角核是个低通滤波器,天然削高频 |
| 走样 | 超过一半采样率的高频,折叠成了假的低频 |
| 抗走样 | 采样前先低通,把会折叠的那部分提前去掉 |
你不需要会算傅里叶变换。 你需要的是"高频=细节、低频=大块"这个直觉,以及看到论文里写 "low-pass"、"high-frequency detail"、"spectrum" 时知道它在说什么——这就是读超分和抗锯齿文献的入场券。
锐化的标准做法叫反锐化蒙版(unsharp mask),公式是:
括号里"原图减模糊版"就是只剩高频的那部分(因为模糊版 = 低频,原图 = 低频+高频)。乘个系数加回原图,就是"高频被抬高了"。名字里的 "unsharp"(不锐利)指的是中间那个模糊版——用一张糊图来把原图变清楚,这个反直觉的名字困扰过很多人。
7. 缩小为什么必须先低通
现在回到开场第 1 问:缩小为什么会产生原图没有的花纹?答案藏在放大与缩小的区别里。
放大和缩小是两个完全不同的问题:
| 放大 | 缩小 | |
|---|---|---|
| 目标像素 vs 源像素 | 目标比源多 | 目标比源少 |
| 每个目标像素对应源的一小块(footprint) | 小于 1 个像素 | 好几个像素 |
| 主要风险 | 糊(信息不够) | 走样(信息太多,装不下) |
| 解法 | 挑个好核去猜 | 先低通,再抽样 |
缩小 4 倍时,输出图的每一个像素,代表的是原图 4×4 = 16 个像素那么大一片区域。要想正确地代表这 16 个像素,就得把它们都考虑进来。
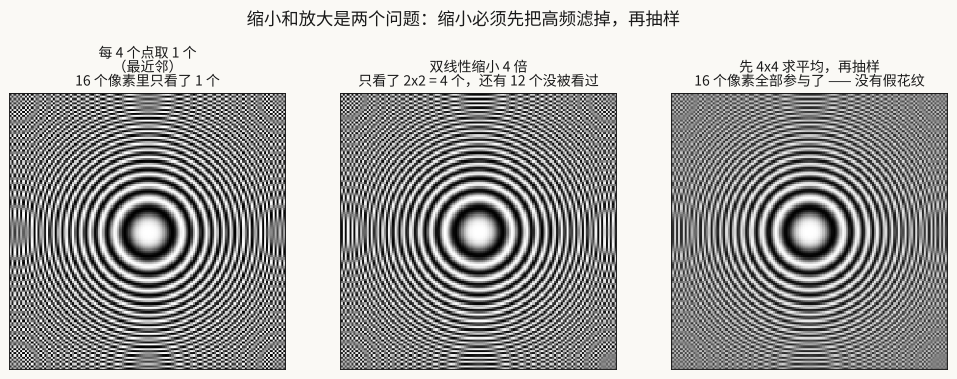
图左:最近邻,16 个像素里只看了 1 个——摩尔纹最严重。图中:双线性缩小 4 倍,只看了 2×2 = 4 个,还有 12 个从来没被读过——摩尔纹依然明显。图右:先做 4×4 平均再抽样,16 个像素全部参与,假花纹消失。
这就是开场第 1 问的答案:双线性始终只有固定的 2×2 邻域,缩得越狠,它相对目标像素 footprint 漏看的像素越多,漏掉的部分折叠成假花纹,走样越严重。小幅缩小时问题可能不明显,但严格的抗走样滤波仍应随缩放比例扩大覆盖范围。双线性不是万能的抗走样手段,它只是个固定 2 抽头的滤波器。
多级缩略图在解决什么
每次缩小都现场做一次大范围平均,太贵了——而且同一张图像会被反复以不同比例缩小。
多级缩略图的思路是把这件事预先做好:把图像逐级减半,每一级都是上一级"先低通再抽样"的结果,存成一串。
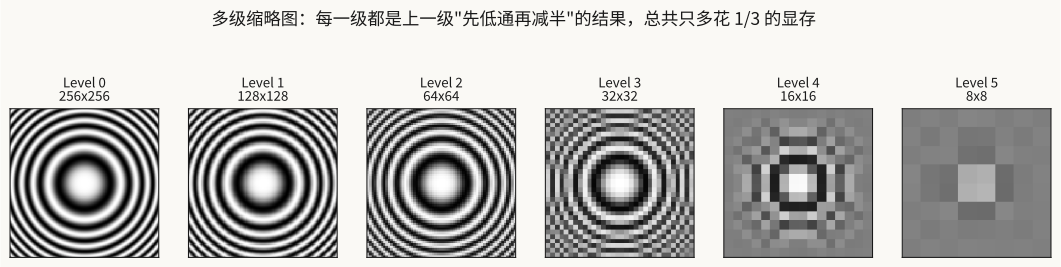
采样时,GPU 根据"这个像素覆盖了图像上多大一片"自动挑一级来读——判断依据是相邻像素之间采样位置变了多少(速查表里的 dFdx/dFdy 量的就是这件事)。
代价只有 1/3 的额外显存(),换来的是缩小场景下的正确性和速度。
自测
问题 1:缩小为什么会产生原图没有的花纹?
缩小就是"用一个像素代表原图的一大片区域"。要是不把整片区域先平均掉(低通),而是直接挑一个或几个像素,那些细密的高频条纹装不下,就会折叠成假的低频——你看到的粗条纹是采样凭空造出来的,原图里根本不存在。而且高频一旦折叠成假低频,就和真的低频混在一起,后处理无法再可靠地把它们分开,只能事前防。
问题 2:采样要不丢信息,条件是什么?
奈奎斯特采样定理给了明确的线:采样频率必须超过信号最高频率的两倍。翻译成缩图的操作就是:缩 倍,就得用能覆盖 像素的滤波;目标越小,滤波的覆盖范围要越宽。以后看到任何"改变分辨率"的代码,先问一句:这是放大还是缩小?放大怕糊(信息不够,挑个好核去猜);缩小怕走样(信息太多,装不下,滤波范围要盖住缩放比例)——两个问题,两套解法。
问题 3:卷积这个操作在干什么?
一个滑动的加权和:给每个像素,把它周围一圈邻居按一组固定的权重加起来。换一组权重就换一种效果——权重和为 1 的核保亮度(模糊、锐化),权重和为 0 的核提取变化(边缘检测)。用频域的话说得更准:模糊 = 砍高频(低通),锐化 = 抬高高频。本篇"采样前先低通"用的正是这个工具。
1. 走样和"细节丢失"有什么本质区别?
细节丢失是少了东西,走样是多了原本不存在的东西。
高频成分不会安静消失,它会折叠成假的低频混进画面里(摩尔纹、闪烁)。这比丢细节严重,因为你无法在事后区分哪些低频是真的、哪些是折叠出来的,所以没法靠后处理修复。
唯一的解法是在采样之前把高频去掉。
2. 一个卷积核的九个权重加起来等于 0,这个核大概是干什么的?
提取变化,也就是边缘检测。
权重和为 0 意味着:面对一片颜色完全一样的区域,加权和必然是 0(输出黑色)。只有当邻域内存在差异时,输出才非零。
对照:权重和为 1 的核(模糊、锐化)保持整体亮度不变。看权重和是判断一个陌生核在干什么的最快办法。
3. 把一张 1024x1024 的图像缩小到 128x128,双线性够用吗?
远远不够。 缩小 8 倍,每个输出像素代表源图 8×8 = 64 个像素,而双线性只读 2×2 = 4 个——60 个像素从没被看过,摩尔纹会非常严重。
正确做法是用多级缩略图(GPU 会自动挑到合适的层级),或者手动做多次逐级减半的低通+抽样。
4. 反锐化蒙版为什么叫"不锐利"蒙版?
因为公式中间那个 用到了一张模糊(unsharp)的图。
原图 = 低频 + 高频,模糊版 ≈ 低频,两者相减就得到了纯高频。把这个高频乘个系数加回原图,高频被抬高,画面看起来更锐。
名字描述的是中间步骤用的素材,不是最终效果——用一张糊图来把原图变清楚。
5. 模糊一张图时,先把图缩到四分之一再模糊,和原尺寸直接模糊,哪种省算力?画面差别重要吗?
先缩再模糊省得多。缩到 1/4 边长意味着像素数变成 1/16,后续每一次模糊读写都便宜 16 倍;模糊半径还可以按同样比例缩小,卷积核变小,每个像素要读的邻居也变少——两头都省。
画面差别:理论上会有。缩 4 倍需要 4×4 的覆盖范围,而随手一缩往往只看 2×2 邻域,没被读到的那些像素会折叠成走样;高频一旦折叠成假低频,后面的模糊在数学上撤销不了它。要保细节,就得换成能覆盖整个缩放比例的滤波(box 平均、多级缩略图、或多次逐级减半)。
差别重不重要,看用途:目标本来是一张强模糊图时,许多残余变化会被模糊本身压下去,误差可能不显眼——这是拿一点画质换带宽和算力的取舍,是否可接受要靠实际模糊半径、输入内容和画质测试验证,不能把"后面还有模糊"当成严格的抗走样证明。但同样的做法若用在需要保留细节的场合(比如生成一张要给用户看的缩略图),走样就会露出来,是实打实的 bug。
同一段代码是不是正确,取决于它的下游要什么。
小结
| 概念 | 一句话 | 要点 |
|---|---|---|
| 采样 | 在连续的东西上隔一段取一个值 | 渲染、图像、动画帧都是采样 |
| 走样 | 高频伪装成假低频 | 多了假东西,不是少了真东西 |
| 奈奎斯特 | 采样率要超过最高频率的两倍 | 推论:采样前必须先低通 |
| 摩尔纹 | 二维走样的样子 | 缩小细密图像时最常见 |
| 卷积 | 滑动的加权和 | 换一组权重就换一种效果 |
| 看权重和 | 和为 1 保亮度,和为 0 提取变化 | 判断陌生核的最快办法 |
| 频域 | 低频=大块,高频=细节 | 模糊=低通,锐化=抬高高频 |
| 反锐化蒙版 | 原图 + λ×(原图 − 模糊版) | 名字说的是中间素材 |
| 放大 vs 缩小 | 放大怕糊,缩小怕走样 | 两个问题,两套解法 |
| 缩小的规则 | 滤波范围应随目标 footprint 扩大 | 双线性固定为 2×2,大幅缩小时明显不够 |
| 多级缩略图 | 预先算好的一串低通版本 | 只多花 1/3 显存 |
延伸阅读
- GAMES101 Lecture 6:Rasterization 2(Antialiasing and Z-Buffering):https://games-cn.org/intro-graphics/
- 3Blue1Brown《傅里叶变换的可视化》:https://www.bilibili.com/video/BV1pW411J7s8
- Scratchapixel: Introduction to Signal Processing:https://www.scratchapixel.com/lessons/mathematics-physics-for-computer-graphics/introduction-to-shading/introduction-to-signal-processing.html
觉得有用?关注公众号「阿豪讲Framework」
Android 系统开发,新文章第一时间推送。