
插值
插值
1. lerp:一切插值的原子
已知两个值,求中间某个位置的值。 最朴素的答案是按距离加权平均,这就是线性插值(linear interpolation,简称 lerp):
是"走到哪儿了": 时结果是 , 时是 , 时是两者的平均。
算一个:,,
两种写法值得都记住。 少一次乘法, 更容易看出"这是一个权重和为 1 的加权平均"——第 4 节要用后一种视角。
超出 时,lerp 变成外插(extrapolation): 会得到超出 的值。数学上完全合法,但在图像上通常意味着出事了——颜色可能跑到 之外,需要 clamp。
2. 一维:最近邻 vs 线性
现在有一排已知的采样点,要重建出中间所有位置的值。
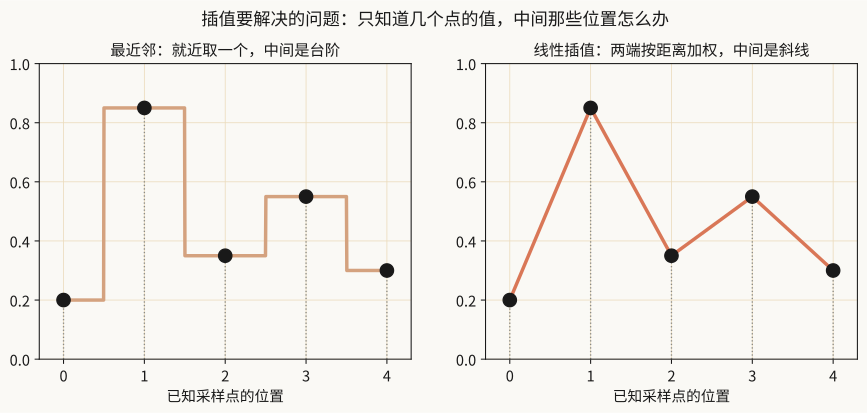
图左:最近邻——就近抓一个用,结果是一串台阶。图右:线性插值——两端按距离加权,结果是折线。
这就是问题 1 答案的一半:任意位置的值来自按距离加权——"线性"指的就是右图那条线性加权的斜线;不加权、就近抓一个,就是左图的台阶。另一半答案在第 3 节:二维上这件事要横竖各来一轮。
台阶在图像上就是方块感(锯齿)。一个 100×100 的图层被拉到 300×300,最近邻会让每个原始像素变成一个 3×3 的实心方块,边缘全是直角锯齿。
3. 双线性:三次 lerp 就完事
二维图像的采样点通常落在四个源像素中间。双线性插值(bilinear interpolation)的做法是:先横着 lerp 两次,再竖着 lerp 一次。
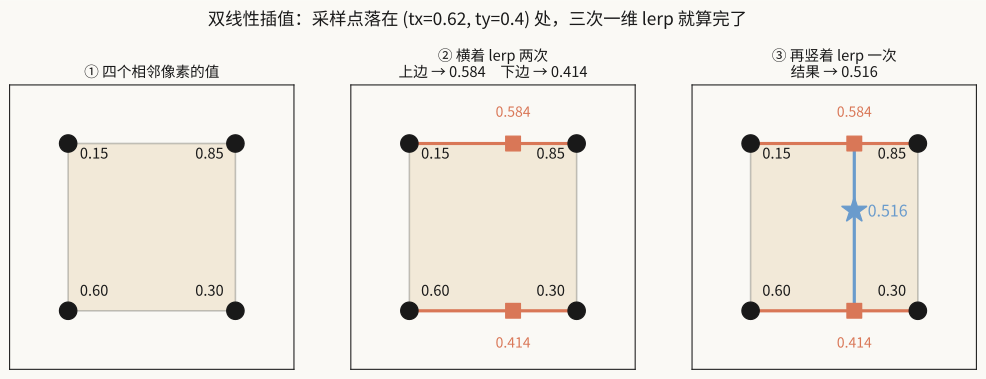
跟着算一遍。四个角的值分别是 、(上边两个),、(下边两个),采样点落在 :
① 上边那条 lerp:
② 下边那条 lerp:
③ 竖着再 lerp 一次:
"双线性"这个名字就是这么来的:两个方向各做一次线性插值。整件事是 4 次取值 + 3 次 lerp,一共不到十次乘加。
换个顺序结果一样。 先竖着 lerp 两次再横着 lerp 一次,得到的还是 0.516。这和第 2 篇讲的"矩阵乘法不能换顺序"不冲突——那说的是变换的复合,这里说的是两个方向上独立的加权,本来就互不干扰。
重要的是这件事有多便宜。 在 GPU 上,这次双线性插值由专做采样的固定功能硬件直接做掉,和一次最近邻采样几乎一样快,不占可编程 ALU 的预算。这就是为什么图层一被缩放,合成器就无脑切到线性采样。
4. 换个视角:插值 = 用一个"核"分配权重
现在做一次视角切换,这一节是理解后面所有内容的钥匙。
回到 lerp 的第二种写法:。它是一个加权平均,权重是 和 ,加起来正好是 1。
把这个想法推广:求某个位置的值 = 把周围的邻居按某种权重加起来。 而"权重怎么分配"可以画成一条曲线,扣在采样点上——这条曲线叫重建核(reconstruction kernel),或者简称核(kernel)。
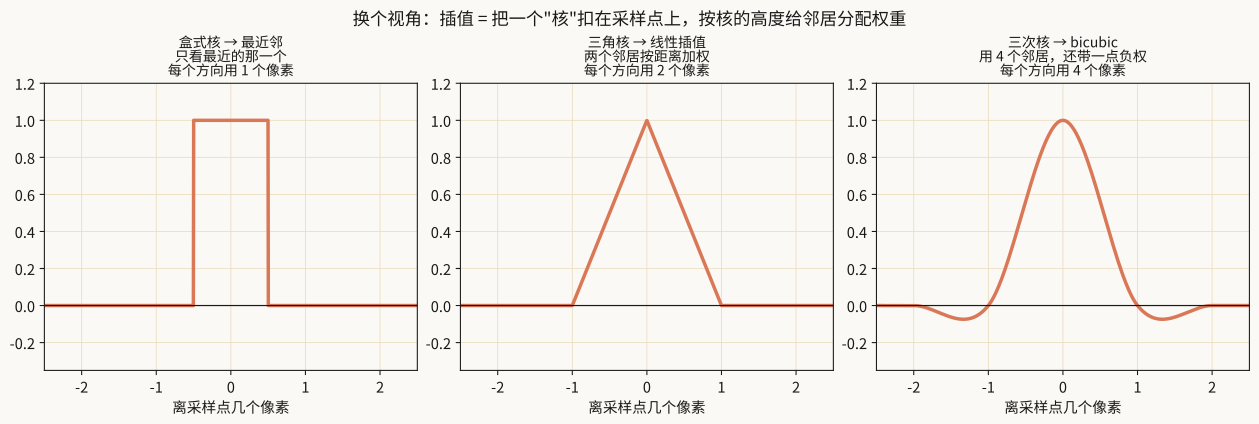
| 核的形状 | 对应的滤波方式 | 每个方向用几个像素 |
|---|---|---|
| 盒式核(box)——一个方块 | 最近邻 | 1 |
| 三角核(tent)——一个三角形 | 线性 / 双线性 | 2 |
| 三次核(cubic)——中间高、两侧带负值 | bicubic | 4 |
三角核的形状恰好就是 lerp 的权重函数:离得越近权重越高,一个像素之外降到 0。所以"双线性插值"和"用三角核做卷积"是同一件事的两种说法。
这个视角的价值在于:它把"插值"和"滤波"统一了。 一旦你把插值看成"扣一个核上去加权",就可以问"换个核会怎样"——而不同的核给出不同的画质、不同的代价。这正是第 7 篇的主线,也是所有超分算法的起点。
注意三次核两侧带负权重。负权重的作用是"把边缘两侧往相反方向推一把",从而抵消一部分模糊、让边缘更锐。代价是可能产生振铃(ringing)——强边缘旁边冒出一圈不该有的亮边或暗边。
5. 双线性放大为什么发糊
现在回答问题 3。
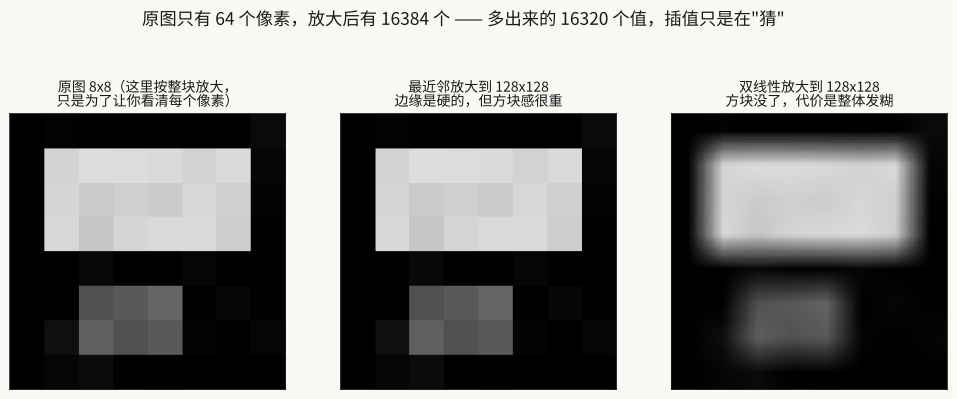
图:一张 8×8 的小图放大到 128×128。中间是最近邻——边缘是硬的,但方块感很重。右边是双线性——方块没了,但整体明显发糊。
先说一句最要紧的:
原图只有 64 个像素,放大后有 16384 个。多出来的 16320 个值,原始数据里根本不存在。插值不是在"恢复"信息,它只是在用一条规则猜。
那为什么偏偏是"糊"这种猜法?看核的形状就知道:三角核是一个平滑的加权平均。加权平均会把相邻的值往中间拉,变化剧烈的地方(也就是边缘)被拉平了。
用第 7 篇会展开的语言说:三角核是一个低通滤波器,它天然会削掉高频。而边缘和细节正是高频。 所以"双线性 = 平滑 = 丢细节"不是实现的缺陷,是这个核的数学性质。
换更好的核能改善,但改善有上限。 bicubic 的负权重能找回一部分锐度,Lanczos 更进一步,但它们都只是在"用已有的 64 个数猜"这个框架内做得更聪明——猜不出原图里就没有的细节。
这就是超分要解决的问题
传统放大方法的天花板就在这儿。经典的一代做法是 "先插值、再锐化" :用 bicubic 之类的核放大,接受它带来的模糊,然后叠一次锐化(比如反锐化蒙版)把一部分清晰感找补回来。
而基于学习的超分做的是另一件事:它见过大量"高清图缩小成低清图"的样本,于是能对"这块糊掉的地方原来长什么样"给出一个有依据的猜测——它引入了训练数据里的先验信息,而不只是在这 64 个数里做加权平均。
理解这个区别,比会背任何一个超分模型的结构都重要。
6. 重心坐标:三角形内部的插值
前面讲的都是"在网格上插值"。逐像素填充阶段(模块二展开)面对的是另一个形状:三角形。
顶点上有位置、颜色、采样坐标、法线,而三角形内部成千上万个像素,每个都需要一份自己的值。怎么算?
答案是重心坐标(barycentric coordinates)。
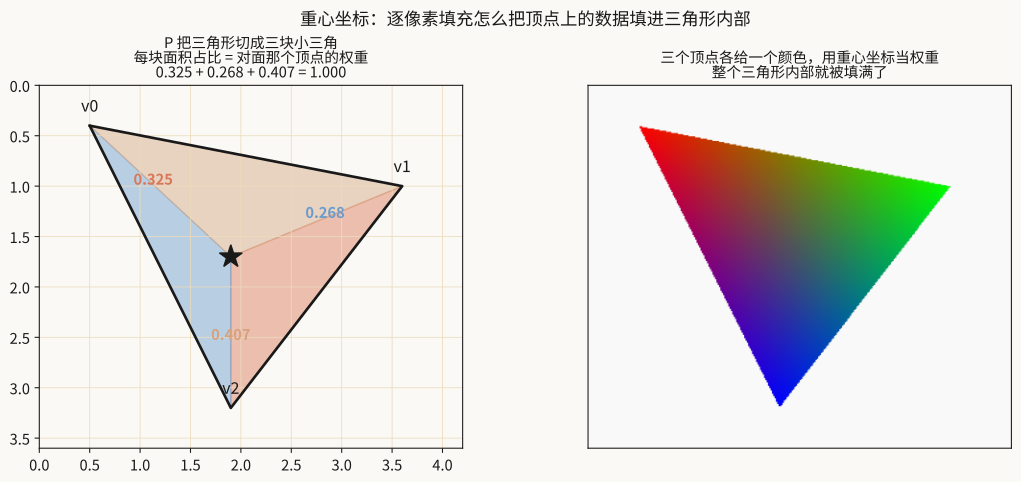
图左:三角形内一点 把它切成三块小三角形。每块的面积占比,就是它对面那个顶点的权重。图中三个权重显示为 0.325、0.268、0.407,加起来是 1.000。图右:三个顶点各给一个颜色,用这三个权重加权,整个三角形内部就被填满了。
写成公式:
任何顶点上的属性(颜色、UV、法线)都用同一组 加权,就得到了内部任意一点的值。
这三块面积怎么算? 第 1 篇讲过的二维叉积—— 就是三角形面积。所以重心坐标和"判断点在不在三角形内"用的是同一组叉积结果:三个叉积符号一致说明在内部,三个叉积的值除以总面积就是权重。一次计算,两个用途,这也是逐像素填充的实现里这两件事总是写在一起的原因。
一个必须知道的坑:在透视投影下,直接用屏幕空间的重心坐标去插值采样坐标是错的——远处被压缩过,屏幕上等距的地方在三维空间里并不等距。正确做法是"透视校正插值"。对顶点属性 和裁剪空间分量 ,先分别插值 与 ,再用两者相除:
分母的倒数就是该位置重建出的 ;不能只插值 后含糊地"乘回来"。现代 GPU 默认执行这套校正,而 shader 里的
noperspective修饰符会关闭它。
自测
问题 1:像素之间的任意位置,颜色从哪来?
来自插值:用周围已知像素的值,按距离加权算出来。一维是两端按距离加权(第 2 节);二维是双线性——采样点落在四个源像素中间,横着 lerp 两次、竖着 lerp 一次(第 3 节)。实验图 m1-06-upscale-compare.svg 右格里每个平滑过渡的像素,都是这样加权出来的。
问题 2:双线性放大听着复杂,为什么实际上只是三次 lerp?
因为两个方向的加权互相独立:先横着 lerp 两次,得到上边、下边各一个中间值,再拿这两个中间值竖着 lerp 一次(第 3 节)。一共 4 次取值、3 次 lerp、不到十次乘加——所以它和最近邻几乎一样便宜。
问题 3:放大为什么发糊?
因为放大后多出来的像素,在原始数据里根本不存在,插值只能拿已有的数来猜(第 5 节)。双线性用的三角核是一个平滑的加权平均,数学上就是低通滤波,必然削掉高频——而边缘和细节正是高频。这不是实现缺陷。换更好的核(bicubic、Lanczos)能改善,但都猜不出原图里没有的细节;突破天花板要靠超分引入训练数据的先验。
顺带把一个边界说清:本篇只处理了放大。把一个图层大幅绘小是另一回事——一个目标像素要代表成百上千个源像素,本篇讲的核都帮不上忙。大幅缩小带来的走样和它的常见解法,下一篇专门讲。
以后再看到任何一个"重采样"的地方,先问两件事:目标比源大还是小(放大 / 缩小,两套解法),以及用的是什么核(核的形状决定画质和代价)。
1. lerp(0.2, 0.9, 0.25) 等于多少?
用另一种写法验算: ✓
2. 一次双线性采样,一共做了几次取值、几次 lerp?
4 次取值,3 次 lerp(横着两次、竖着一次)。
值得记住的是:在 GPU 上这整套是专做采样的固定功能硬件做的,和一次最近邻采样的开销几乎一样——所以"要不要开双线性"在移动端基本不是性能问题。
3. 为什么说"双线性 = 用三角核做加权"?
因为 lerp 的权重是 和 :离得越近权重越大,距离超过一个像素时权重降到 0。把这个权重随距离的变化画出来,正好是一个三角形。
这个视角的价值是把"插值"和"滤波"统一了——换个核形状就是换一种滤波方式,而不同的核对应不同的画质和代价。
4. 一张 100x100 的图用 bicubic 放大到 400x400,能"恢复"出原图不存在的细节吗?
不能。
放大后有 160000 个像素,原图只有 10000 个。bicubic 比 bilinear 锐一些(靠核两侧的负权重),但它仍然只是在这 10000 个已知数上做加权——它没有任何额外的信息来源。
基于学习的超分之所以能做得更好,是因为它引入了训练数据里的先验知识("这类糊掉的图像通常原来长什么样"),那是框架之外的信息。
5. 三角形三个顶点的颜色分别是红、绿、蓝,某个像素的重心坐标是 (0.5, 0.3, 0.2),它是什么颜色?
,也就是 RGB ——一个偏红的暗棕色。
三个权重加起来必须是 1,这保证了结果不会整体偏亮或偏暗。
(严格说,在透视投影下还要做透视校正:分别插值"属性/"与"",再让前者除以后者。现代 GPU 默认就这么干。)
小结
| 概念 | 一句话 | 要点 |
|---|---|---|
| lerp | ,按距离加权平均 | 一切插值的原子 |
| 最近邻 | 就近抓一个,结果是台阶 | 不做额外设置时的默认采样 |
| 双线性 | 横两次竖一次,4 取值 3 lerp | 一族绘制 API 里的"线性过滤"选项就是它 |
| 双线性的代价 | 几乎为零,专做采样的固定功能硬件直接做 | 所以缩放时无脑开 |
| 重建核 | 插值 = 用一个核给邻居分配权重 | 盒式=最近邻,三角=双线性,三次=bicubic |
| 为什么发糊 | 三角核是低通滤波,必然削高频 | 不是缺陷,是数学性质 |
| 放大的天花板 | 多出来的像素在原图里没有数据 | 超分靠的是训练数据的先验 |
| 重心坐标 | 三块小三角的面积占比当权重 | 逐像素填充阶段用它填顶点属性;和"点在不在三角形内"共用叉积 |
| 透视校正 | 插值属性/ 与 ,再相除 | GPU 默认开,noperspective 关掉它 |
| 放大 ≠ 缩小 | 大幅缩小的走样是另一回事 | 下一篇专门处理 |
延伸阅读
- GAMES101 Lecture 9:Shading 3(重心坐标与透视校正):https://games-cn.org/intro-graphics/
- Scratchapixel: Perspective-Correct Interpolation:https://www.scratchapixel.com/lessons/3d-basic-rendering/rasterization-practical-implementation/perspective-correct-interpolation-vertex-attributes.html
- ImageMagick 官方文档《Resampling Filters》(各种核的对比):https://legacy.imagemagick.org/Usage/filter/
觉得有用?关注公众号「阿豪讲Framework」
Android 系统开发,新文章第一时间推送。