
投影与深度
投影与深度
1. 投影要解决的问题:把一个盒子装进标准盒子
到第 4 篇为止,场景已经被搬到了相机空间:相机在原点,看向 方向。
现在要决定两件事:看得见多大范围,以及怎么把这个范围里的东西压成一张二维图像。
看得见的那块空间叫视景体(view volume)。它有两种形状:

图:上排是两种视景体的立体形状。正交投影的是个长方体——远近的取景范围一样宽,适合 CAD 图纸、2D 游戏、UI;透视投影的是个截头金字塔(叫视锥,frustum)——越远的地方取景范围越宽。下排是同样这四张等大的卡片投影之后、屏幕上真正的样子:正交画出来四张一模一样,远近完全分不出来;透视画出来越远越小,还朝画面中心收拢。
上排四张卡片是等大的,这不是画错了:上排画的是投影之前的相机空间,卡片本来就等大。"近大远小"是投影这一步才发生的事,所以光看视景体的形状看不到它——必须看下排。
视锥还顺带管着另一件事:

图:出自 LearnOpenGL CN《坐标系统》(NEAR / FAR PLANE = 近 / 远平面,FOV = 视野角,GETS DISCARDED = 会被丢弃)。落在近平面之前或远平面之后的东西——图里那个蓝色立方体——直接被裁掉,压根不进入后面的管线。"看得见多大范围"和"什么会被裁掉"是同一句话的两种说法。
两种投影都要把自己的视景体,装进同一个标准的立方体。这个标准立方体就是 NDC(Normalized Device Coordinates,归一化设备坐标)。
为什么要统一成一个标准盒子?因为后续管线希望面对固定的数值范围——"在不在屏幕里"退化成几次固定范围比较。GPU 通常会在透视除法之前,先用裁剪坐标中与这个标准盒子等价的齐次范围完成裁剪;除法之后才真正得到 NDC。 通常落在 ,深度则视约定使用 或 。
2. 正交投影:一次平移加一次缩放
正交投影最简单,它就是把一个长方体搬进标准立方体,两步:
- 先把长方体的中心挪到原点(平移);
- 再把它缩放成 的大小(缩放)。
假设视景体在 方向是 (left/right), 方向是 (bottom/top)。沿用本篇"相机看向 "的约定,并用正数 表示近平面、远平面到相机的距离,所以它们在相机空间里的坐标分别是 、。
中心点在 。各方向的长度是 、、。下面先采用 这种约定:近平面映射到 、远平面映射到 。平移和缩放两个矩阵乘起来:
看着吓人,其实只有两件事:对角线上是"缩放到 2 个单位",第四列是"先把中心挪到原点"。 方向的缩放带负号,是因为视线沿 ,距离越远,相机空间的 越小。用第 3 篇的分区读法一眼就能拆开。
验算一下:取 ,第一行算出 ✓ 右边界正好落在 NDC 的 上。
注意第四行还是 ——正交投影不产生透视,输出的 恒为 1,不需要透视除法。
若目标是另一种约定 ,只需把第三行改成把 映射到 0、 映射到 1;正交投影"平移 + 缩放"的本质不变。
没有透视是缺点,也是优点。在真实的建模软件里,两种投影是这样的:

图:出自 LearnOpenGL CN《坐标系统》(PERSPECTIVE = 透视,ORTHOGRAPHIC = 正交)。同一个模型:左边透视,远端明显收窄,看着"真实";右边正交,本来平行的边在画面上还是平行的。建模时正交更好用,因为屏幕上量到的尺寸就是真实尺寸,不被距离干扰——这也是 CAD 图纸和 2D 游戏用正交的原因。
3. 透视投影:先把视锥挤成盒子
透视的效果,看一眼这个就懂了:

图:出自 LearnOpenGL CN《坐标系统》。铁轨的两条边在真实世界里是严格平行的,画面上却在远处交于一点。
透视投影的目标就是把这件事算出来。具体地说:一个物体在画面上的大小,应该正比于 。
问题来了:矩阵乘法只会做加权求和,它做不了除法。
第 3 篇已经给过答案:把要除的东西放进 分量,让透视除法去做这次除法。
所以透视投影矩阵干的事情是:把顶点的 (也就是它离相机的距离)塞进输出的 里。第四行不再是 ,而是 :
后面管线做透视除法时, 和 都会被 除——离得越远( 越大),除完越小。近大远小就是在这一步发生的。

图:还是那四张等大的卡片。① 它们在视锥里,一张比一张远。② 挤压这一步把视锥的远端按 距离 收窄,掰成一个方盒子(灰虚线是原来的视锥)——远处的卡片跟着被压小,"近大远小"就发生在这里。③ 归一化到 NDC——注意四张卡片在深度方向上全挤向了远端(深度 0.55 / 0.78 / 0.90 / 0.98),这是第 4 节的主题。
理解透视投影的最好方式:它 = 一次"把视锥挤成长方体"的挤压 + 一次正交投影。挤压负责近大远小,正交负责装进标准盒子。
一个常见的写法是用视野角 和宽高比 来表达:
要记的只有最后一行那个 ——它是整个透视效果的来源。前两行是"视野多大",第三行是"深度怎么映射",都是可以现推的细节。
从裁剪坐标到 NDC:归一化到底怎么算
这里的"归一化"不是把向量的长度变成 1,而是把一个变化的坐标范围重新映射到固定区间。
先看一维。把任意区间 映射到 ,可以分成三步:减去左端点、除以区间长度、再把 拉成 :
所以正交投影把 映射到 NDC 时,直接计算:
和 完全同理。正交投影输出的 ,因此矩阵乘完再除以 ,数值不变——前面的正交投影矩阵其实已经把结果放进了 NDC 范围。
透视投影多了一层麻烦:视锥在不同距离处的宽和高不一样。 令
其中 是点到相机的距离。在距离 处,视锥的上下边界是 ,左右边界是 。要把它们映射到 ,数学上应该计算:
分母里的 对每个顶点都不一样,普通矩阵乘法不能直接做这次除法。于是上面的透视投影矩阵先准备出四个裁剪坐标(clip coordinates):
随后 GPU 做一次透视除法:
把前面的 代进去,正好得到:
这就是"视锥被归一化成标准盒子"真正发生的地方:投影矩阵负责准备分子和分母,透视除法负责完成除法。
深度也除以同一个 。沿用上面矩阵的 约定,把 代入:
时结果是 0, 时结果是 1,所以近平面和远平面正好落到 NDC 深度范围的两个端点。中间那个 也提前暴露了第 4 节要讲的问题:透视深度不是线性的。
举个具体数字。取 、、、,相机空间中的点是 。因为 ,投影矩阵先得到:
除以 :
三个分量都落在标准盒子的范围内,所以这个点可见。距离为 2 时,视锥的半宽正好也是 2;原来的 位于中心到右边界的一半,归一化后自然就是 。
最后补一个容易被流程图省略的细节:GPU 通常在透视除法之前做齐次裁剪。以 约定为例,裁剪条件是:
对于相机前方 的点,把这些不等式同时除以 ,就得到 NDC 的 、。另一种约定只把最后一个条件换成 ,除完以后就是 。深度区间有两种约定: 与 ;哪两家 API 各选哪个、为什么,留到两家都见过之后对比。
完整顺序因此是:
相机空间 → 乘投影矩阵 → 裁剪空间 → 齐次裁剪 → 除以 w → NDC → 视口变换 → 屏幕坐标4. 深度为什么不是线性的
这是本篇最要紧的一节。
透视除法把 也除以了 。结果是:写进深度缓冲的值,和真实距离之间是一个倒数关系,不是线性关系。
以 约定为例,距离 处写进深度缓冲的值是:
验算两个端点: 时得 0, 时得 ✓
关键在中间那个 ——它是个倒数。

图:三条曲线对应三种近平面设置。共同点是:曲线在近处陡峭、在远处几乎躺平。躺平意味着很大一段距离变化,只对应很小一点深度值变化——分辨能力就在那里丢掉了。
一个让人不舒服的数字
取近平面 、远平面 (很典型的设置)。问:深度值用掉一半(也就是 达到 0.5)时,物体离相机多远?
约 0.2。 也就是说:
整整一半的深度精度,花在了 0.1 到 0.2 这 10 厘米上。剩下的 99.8 米,共用另一半。

图:远平面固定为 100。近平面每缩小 10 倍,"一半精度"覆盖的距离也跟着缩小约 10 倍。
这就是那条经典建议的由来:
想改善深度精度,把 near 调大,而不是把 far 调小。
因为精度分布几乎完全由 决定。把 far 从 100 改到 50 收效甚微;把 near 从 0.01 改到 0.1,等于把一半的精度预算从"前 2 厘米"挪到了"前 20 厘米"。
反过来说,"把 near 设得小一点,免得近处的东西被裁掉"是个代价很高的做法——它会把绝大部分深度精度浪费在你几乎不会有物体的贴脸距离上。
5. 深度打架:两个面抢同一个像素
现在可以解释问题 3 了。
深度缓冲是有限位数的整数(常见 16、24 位)。 算出来之后要被量化成整数存起来。远处曲线躺平的那一段,相邻的距离算出来的 差别极小,量化之后可能落到同一个整数上。
一旦两个面的深度值相等,谁在前谁在后就由浮点误差和绘制顺序决定——摄像机稍微一动,两个面就交替获胜,画面上出现闪烁的斑块。这就是深度打架。
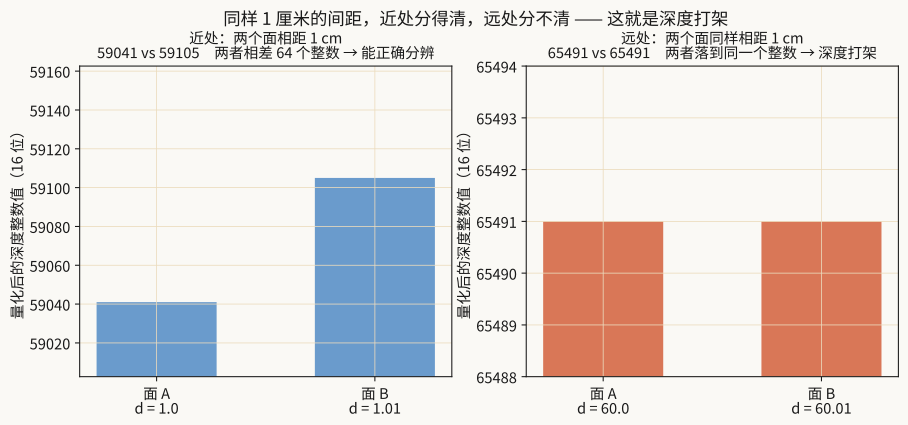
图:、、16 位深度缓冲。两个相距 1 厘米的面:在 1 米处,深度整数值是 59041 和 59105,相差 64,分得清清楚楚;在 60 米处,两个值都是 65491——完全一样,于是开始打架。
排查深度打架的顺序:
- 先看 near 是不是设得太小(最常见,也最容易改);
- 再看两个面是不是真的挨太近(共面的墙和贴花,用 depth bias 或 stencil 解决);
- 深度格式是不是用了 16 位(换 24 位或浮点深度);
- 都不行再考虑 reverse-Z——把近平面映射到 1、远平面映射到 0,让浮点数精度最密集的区间(0 附近)对上深度曲线最平坦的区间(远处)。这一招几乎免费地换回好几位有效精度,现代引擎基本都用。
6. pre-rotation:为什么要乘进投影矩阵
开场三个问题之外,还有一个直接落在投影矩阵上的问题,放在这一节问:显示屏的扫描方向和窗口方向不一致时,这个差异该由谁来抹平?为什么最佳实践是应用把旋转乘进投影矩阵,而不是画完之后再转一次画面?
手机竖着拿,但显示屏的物理扫描方向可能是横的。系统会把这个差异作为一个旋转提示报给应用。这个差异总得有人来抹平,可能的做法有三种:
| 做法 | 代价 |
|---|---|
| 显示控制器在扫描时旋转 | 有些硬件不支持,或者只支持部分角度 |
| 合成器多加一趟旋转 pass | 多读写一整帧的显存带宽,移动端最不能接受的开销 |
| 应用自己把旋转烘进渲染 | 零额外开销 |
第三种就是 pre-rotation。而"烘进渲染"最省事的落点,正是投影矩阵——因为它本来就要被每个顶点乘一次。
具体做法:拿到旋转提示之后,构造一个对应角度的旋转矩阵 ,把投影矩阵换成 :
为什么这是免费的? 因为 是在 CPU 上每帧算一次的 4×4 矩阵乘法,而顶点着色器里那行 gl_Position = uMVP * aPosition 一个字都不用改。旋转这件事被完全吸收进了一个本来就存在的矩阵里。
这就是本节开头那个问题的答案,也是第 2 篇那条结论在真实场景里最值钱的一次应用:变换可以预先乘起来合并,所以多做一次变换,运行时开销可以是零。
别忘了配套的两件事:呈现环节有一个申报机制——应用把旋转乘进自己的投影后,向系统申报"这个旋转我已处理",系统不再转第二次;以及 是 90°/270° 时画面的宽高互换了,viewport 和 scissor 要跟着调。这两处漏掉任何一个,画面要么被转两次,要么被拉伸。
自测
问题 1:远近不同的物体怎样被装进一个标准盒子?
靠投影:每种投影都把自己的视景体搬进同一个标准立方体 NDC(第 1 节)。正交投影最直接——先把长方体的中心挪到原点,再缩放到 (第 2 节);透视投影分两步——先把视锥按 距离 挤成长方体,再当正交投影处理,"近大远小"发生在挤压那一步(第 3 节)。矩阵自己不会做除法:它把顶点的距离塞进 ,由后面的透视除法完成这次除法——实验图 m1-05-perspective-squeeze.svg 的三格正是"视锥 → 挤成盒子 → 归一化"。
问题 2:深度值为什么和距离不是线性关系?
因为透视除法把 也除以了 :写进深度缓冲的值是 ,中间那个 是倒数(第 4 节)。曲线因此在近处陡峭、远处躺平(实验图 m1-05-depth-nonlinear.svg):、 时,一半的深度值花在前 10 厘米上,剩下 99.8 米共用另一半。
问题 3:两个面离得几乎一样远时,画面会发生什么?
可能开始闪烁——深度打架(第 5 节)。深度缓冲的位数有限(常见 16、24 位), 算出来之后要量化成整数;远处曲线躺平,相邻距离算出的深度值差别极小,量化后可能落到同一个整数上。两个面深度相等,谁赢就由浮点误差和绘制顺序决定,相机一动就交替获胜。有 24 位也救不了远处——上一问算过,位数再多也是按倒数分配的,远处的分辨能力早就被挤没了。首选对策是调大 near,其次是 reverse-Z。
1. 正交投影矩阵的第四行是 (0,0,0,1),透视投影是 (0,0,−1,0)。这个差别导致了什么?
正交投影输出的 恒为 1,透视除法除以 1 等于什么都没做——没有近大远小。
透视投影把顶点的 (离相机的距离)塞进了 ,之后 、 都会被这个距离除,离得越远显示得越小。
第 3 篇讲过的"第三行/第四行管透视",在这里落到了实处。
2. 一个顶点的裁剪坐标是 $(2,\,-1,\,3.5,\,4)$。透视除法之后它的 NDC 坐标是多少?在不在标准盒子里?
各分量同除以 :
✓;按本篇使用的 约定, ✓。三个分量都落在标准盒子的范围内,这个顶点可见。
这正是第 3 节"投影矩阵准备分子和分母、透视除法完成除法"的一次演练。
3. near=0.1、far=100,深度值用掉一半时物体在多远?如果把 near 改成 1.0 呢?
:约 0.1998,也就是一半的精度花在了前 10 厘米。
:约 1.9802,一半的精度覆盖到了约 2 米。
代入 解出 即可。
结论:near 调大 10 倍,有效精度范围也大约扩大 10 倍。
4. 同事说"远处两个面深度打架,我把 far 从 1000 调到 500 试试"。有用吗?
基本没用。
深度精度的分布几乎完全由 near 决定, 只影响那个 的整体系数。 从 1000 减到 500,系数从 变成 ,两者都约等于 1,曲线形状几乎没动。
正确的方向是调大 near,或者启用 reverse-Z。
5. 为什么 pre-rotation 说是"零开销"?旋转矩阵不也要参与运算吗?
因为它被吸收进了一个本来就存在的矩阵。
是 CPU 上每帧一次的 4×4 矩阵乘法(几十次浮点运算),而顶点着色器里 uMVP * aPosition 那行代码完全不变——GPU 侧一次额外的乘法都没有。
对比另一条路:让合成器多做一趟旋转 pass,代价是多读写一整帧的显存。在移动端,带宽比算力金贵得多。
小结
| 概念 | 一句话 | 要点 |
|---|---|---|
| 投影的任务 | 把视景体装进标准立方体 NDC | 让裁剪退化成范围比较 |
| 正交投影 | 平移到原点 + 缩放到 2 个单位 | 第四行仍是 ,无透视 |
| 透视投影 | 把 塞进 ,交给透视除法 | 第四行的 是全部秘密 |
| 理解方式 | 透视 = 挤压视锥 + 正交 | 挤压负责近大远小 |
| NDC 约定 | 深度区间有 与 两种 | 哪两家 API 各选哪个、为什么,留到两家都见过之后对比 |
| 深度非线性 | 中间那个倒数是根源 | |
| 精度分布 | 时,一半精度花在前 10 厘米 | 想要精度就调大 near |
| 深度打架 | 远处两个深度量化到同一个整数 | 先查 near,再考虑 reverse-Z |
| pre-rotation | 把屏幕旋转左乘进投影矩阵 | 吸收进已有矩阵 = GPU 侧零开销 |
延伸阅读
- GAMES101 Lecture 4:Transformation Cont.(投影矩阵推导):https://games-cn.org/intro-graphics/
- LearnOpenGL 中文版《坐标系统》:https://learnopengl-cn.github.io/01 Getting started/08 Coordinate Systems/ (本篇的铁轨图、视锥裁剪图、Blender 对比图都引自这里,出处见
assets/external/SOURCES.md) - NVIDIA《Depth Precision Visualized》(reverse-Z 的经典说明):https://developer.nvidia.com/content/depth-precision-visualized
觉得有用?关注公众号「阿豪讲Framework」
Android 系统开发,新文章第一时间推送。