
10. 帧缓冲与后处理:画到别处再加工
10. 帧缓冲与后处理:画到别处再加工
本篇位置:模块二 · 第 10 篇 | 前置:抗锯齿 | 预计阅读:30 分钟
你已经在用它了
只要有图层要做背景模糊,SurfaceFlinger 就不直接往目标 buffer 上画了,而是另开一张画布(libs/renderengine/skia/SkiaRenderEngine.cpp,删去调试与厂商分支):
sk_sp<SkSurface> activeSurface(dstSurface);
// ...
if (requiresCompositionLayer) {
    activeSurface = dstSurface->makeSurface(dstSurface->imageInfo());
    blurCompositionLayer = &layer;
    break;
}画到那个图层时,再把这张离屏画布变成一张可采样的图交给模糊,最后拷回目标:
sk_sp<SkImage> blurInput;
if (blurCompositionLayer == &layer) {
    blurInput = activeSurface->makeTemporaryImage();

    // blit the offscreen framebuffer into the destination AHB. This ensures that
    // even if the blurred image does not cover the screen (for example, during
    // a rotation animation, or if blur regions are used), the entire screen is
    // initialized.
    SkPaint paint;
    paint.setBlendMode(SkBlendMode::kSrc);
    // ... 把 activeSurface 的内容整块画到 dstCanvas 上
}
三个问题:
- 为什么背景模糊非得先画到一张离屏画布上?直接在目标 buffer 上模糊不行吗?
makeTemporaryImage()把刚画完的画布变成了一张可以采样的图。这个"画布 → 贴图"的转换,GPU 上到底发生了什么?- 最后为什么还要整块 blit 一次?注释说是为了"保证整屏被初始化"——不 blit 会怎样?
学完你会什么
- 说清为什么后处理必须先渲染到别处,不能原地改。
- 说清渲染目标和纹理是同一块显存的两种身份。
- 说清"全屏 pass"是什么,为什么它是所有后处理效果的公共外壳。
- 说清后处理链怎么用两张纹理串起任意多个效果。
- 说清 bloom 为什么要降采样,以及为什么这反而更便宜又更好看。
1. 为什么必须画到别处
问题 1 的答案很硬:因为你不能一边读一边写同一块内存。
模糊的定义是"每个输出像素等于它周围一圈输入像素的加权和"(M1 第 7 篇讲的卷积)。如果输入和输出是同一块 buffer,算第 2 个像素时读到的邻居,已经是第 1 个像素被覆盖后的结果,而不是原始值。
这不是效率问题,是正确性问题——算出来的东西根本不是模糊,而是某种沿扫描方向拖尾的怪东西。
更根本地说,这是所有后处理的共同前提:
后处理要读"整张已经画好的图",所以那张图必须已经完整存在于某个地方,且不是正在写的地方。
这就是离屏渲染(offscreen rendering)的全部动机。
2. 渲染目标与纹理:同一块显存的两种身份
现在回答问题 2。
makeTemporaryImage() 听起来像是做了一次转换或拷贝,但 GPU 上通常什么都没搬。
一块显存能以两种身份被使用:
| 身份 | 谁在用它 | 干什么 |
|---|---|---|
| 渲染目标(render target / 颜色附件) | 管线末端的输出合并阶段 | 往里写像素 |
| 纹理(texture) | 片段着色器里的采样器 | 从里读像素 |
makeTemporaryImage() 做的是换个身份:把"刚才那块被写入的显存"包装成一个可采样的对象。数据一个字节都没动。
在 OpenGL 里这套机制叫 FBO(Framebuffer Object,帧缓冲对象)——你创建一个 FBO,把一张纹理挂上去当颜色附件,之后所有绘制就写进那张纹理;画完解绑,那张纹理就能拿去采样。Vulkan 里对应的是 VkImage 加不同的 VkImageView 和 layout。
核心观念只有一句:渲染目标和纹理不是两种东西,是同一块显存的两种用法。建立了这个观念,后处理、阴影贴图(第 8 篇那张深度图就是这么来的)、延迟渲染就全通了。
身份切换不是完全免费的。GPU 需要知道"我要从写模式切到读模式了",中间可能要等待之前的写入真正完成、可能要做缓存刷新或格式转换(Vulkan 里就是显式的 layout transition + barrier)。在移动端 tile 架构上这个代价尤其明显——切换会强制把 tile 内存里的内容写回系统内存,第 11 篇会讲清楚为什么这很贵。
所以后处理 pass 不是越多越好,每多一趟就多一次"写出去再读回来"的完整往返。
3. 全屏 pass:所有后处理的外壳
有了一张画好的纹理,怎么对它做处理?
答案朴素得有点好笑:画两个三角形,盖满整个屏幕。
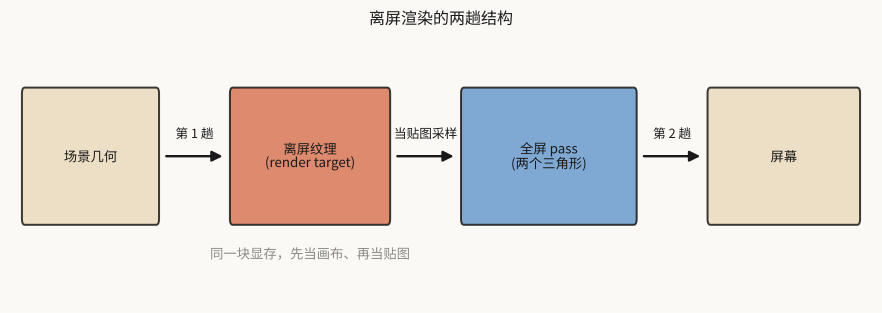
图:第 1 趟把场景画进离屏纹理;第 2 趟画一个盖满屏幕的矩形(两个三角形),它的片段着色器去采样刚才那张纹理,算出新颜色写到屏幕上。
这就是全屏 pass(full-screen pass)。它的结构永远是这一套:
- 顶点:4 个(或用一个大三角形,3 个),覆盖整个屏幕,UV 从 (0,0) 到 (1,1);
- 片段着色器:每个屏幕像素跑一次,输入是上一趟的纹理,输出是处理后的颜色;
- 不需要深度测试,不需要光照,几何复杂度为零。
所有后处理效果的差别,只在那段片段着色器里。模糊是采一圈邻居加权平均;色调映射是套一条曲线;锐化是原图加上高频;边缘检测是一组和为 0 的权重(M1 第 7 篇那张卷积核表全部适用)。外壳完全一样。
这个认知很有用:看到任何一个后处理效果,先在脑子里把它拆成"外壳 + 一段片段着色器",然后只去想那段着色器在算什么。
4. 后处理链:两张纹理就够了
真实的后处理从来不止一个效果,而是一串:提取亮部 → 模糊 → 色调映射 → 抗锯齿……
每一步都要"读上一步的结果、写到新地方"。难道要准备一串纹理?
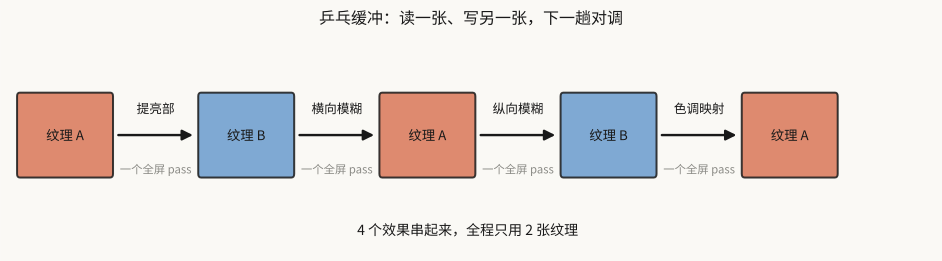
图:4 个效果串起来,全程只用 2 张纹理——读 A 写 B,下一趟读 B 写 A,来回对调。
这叫乒乓缓冲(ping-pong buffering)。因为每一趟只需要"上一趟的结果",更早的中间结果可以立刻丢弃,所以两张就够周转。
一个常见的实现技巧:高斯模糊是可分离的——一次二维模糊等价于先横着模糊一遍再竖着模糊一遍。 的卷积核要采 次,拆成两趟一维只要 次。 时是 81 次对 18 次,省了 4.5 倍。代价是多一趟 pass,但在核较大时非常划算。图里的"横向模糊 → 纵向模糊"两步就是这个。
5. bloom:为什么降采样反而是对的
bloom(辉光)是最典型的后处理链:很亮的东西周围应该有一圈光晕,模拟真实相机镜头里的光散射。
做法是:提取亮部 → 大范围模糊 → 加回原图。
难点在"大范围"。光晕要扩散几十上百个像素,直接在全分辨率上做这么大的模糊,卷积核会大到无法接受。
解法是在低分辨率上做。
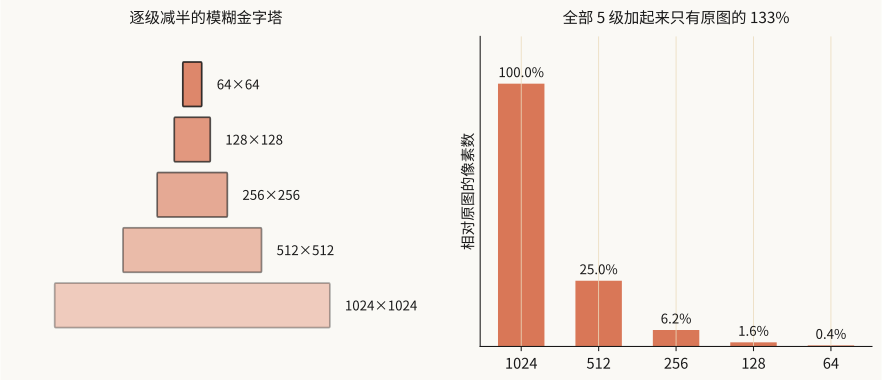
图:逐级减半的模糊金字塔。1024 → 512 → 256 → 128 → 64,各级像素数分别是原图的 100%、25%、6.25%、1.56%、0.39%。全部 5 级加起来只有原图的 133%——比在全分辨率上做两次模糊还便宜。
在 1/16 分辨率上用一个小核模糊,等价于在全分辨率上用一个 16 倍大的核。降采样不是为了省,是让"大范围模糊"这件事在计算上可行。
而且这里有个额外的好处:bloom 的目标本来就是一团糊的光晕,降采样丢掉的高频细节根本不需要。M1 第 7 篇讲过降采样会走样,但那里也说了——当下游本来就要一张糊图时,走样引入的误差看不出来。SurfaceFlinger 的背景模糊先缩到 1/4 再模糊,用的是完全相同的逻辑。
这是个值得记住的通用取舍:一个效果如果本来就要丢高频,那就先降分辨率再做,几乎总是划算的。
6. 色调映射与 MRT
再补两块常见拼图。
色调映射(tone mapping)解决的是:渲染是在高动态范围里算的(太阳的亮度可以是纸张的几千倍),而屏幕只能显示有限范围。需要一条曲线把 HDR 压进 SDR,还不能把亮部全压成一片死白。
M1 第 8 篇和第 9 篇已经把 gamma、PQ/HLG 这套讲透了。管线上只需要知道:色调映射是后处理链的最后几步之一,必须在线性空间做完所有计算之后、编码输出之前。
MRT(Multiple Render Targets,多重渲染目标)是另一件事:一次绘制可以同时往好几张纹理里写。片段着色器输出多个值,分别落到不同的渲染目标上。
它最重要的用途是延迟渲染(deferred shading):第一趟不算光照,只把每个像素的位置、法线、albedo、粗糙度分别写进几张纹理(合称 G-buffer);第二趟用一个全屏 pass 读这些纹理,一次性把所有光照算完。
好处是光照计算和几何复杂度解耦——场景里有几百个光源也不会随三角形数量爆炸。代价是 G-buffer 占用大量显存和带宽,这在移动端通常直接判死刑(第 11 篇)。
⚠️ 别搞混
你熟的 Surface / BufferQueue 和这一篇的渲染目标,都是"画到哪儿",但完全不在一个层级:
Surface / BufferQueue | 渲染目标 / FBO | |
|---|---|---|
| 作用域 | 跨进程,生产者-消费者 | 进程内,纯 GPU 侧 |
| 有同步语义吗 | 有——fence、acquire/release、多缓冲 | 没有,只是一块显存 |
| 谁管理生命周期 | gralloc + BufferQueue | 应用自己(GL/Vulkan 对象) |
| 一帧几个 | 每个 Surface 通常 2~3 个轮转 | 一趟渲染一个,可能几十个 |
| 能被别人读吗 | 消费者进程通过 buffer 拿到 | 同进程内当纹理采样 |
| 典型大小 | 屏幕大小 | 任意,常见 1/2、1/4 屏 |
一个是跨进程交付一帧成品的通道,一个是进程内做中间计算的草稿纸。
代码里那个 dstSurface(对应最终要交出去的 AHardwareBuffer)和 activeSurface(临时草稿)的区别,正是这条分界。
回到源码
问题 1:为什么必须先画到离屏画布?
因为不能一边读一边写同一块内存。模糊要读每个像素周围一圈的原始值,如果输入输出是同一块 buffer,算到后面读到的已经是被覆盖过的结果,出来的东西根本不是模糊。
所有后处理都受这条约束:它要读一张完整的、不再变化的图。
问题 2:makeTemporaryImage() 发生了什么?
换了个身份,数据没搬。同一块显存,之前当渲染目标被写入,现在被包装成可采样的纹理对象。这就是 OpenGL 里 FBO + 纹理附件那套机制的 Skia 版本。
但身份切换不是完全免费的——GPU 要确保之前的写入已完成,可能涉及缓存刷新和格式转换。在移动端 tile 架构上这个代价格外明显,所以后处理 pass 不是越多越好。
问题 3:最后那次 blit 不做会怎样?
屏幕上会有一部分区域是没被写过的垃圾内容。
注释说得很清楚:模糊的结果不一定盖满整屏——旋转动画期间画面是斜的、或者只对局部 blur region 做了模糊。这些情况下,离屏画布上有内容的只是一部分,而最终那块 AHardwareBuffer 是新拿的、内容不确定。
所以要用 kSrcOver 之外的 kSrc(直接覆盖,不读背景,第 6 篇讲过它更快)把离屏画布整块拷过去,保证目标 buffer 每个像素都被明确写过一次。
这是个很典型的防御:不要假设目标 buffer 是干净的。
自测
1. 为什么模糊不能在原 buffer 上原地做?
因为输入和输出会互相污染。
模糊的每个输出像素依赖它周围一圈输入像素的原始值。原地做的话,算第 2 个像素时读到的邻居已经是第 1 个像素被覆盖后的结果。
出来的不是模糊,而是沿扫描方向拖尾的怪东西。这是正确性问题,不是效率问题。
所有后处理都受同一条约束:要读一张完整的、不再变化的图。
2. "渲染目标"和"纹理"是什么关系?
同一块显存的两种身份。
当渲染目标时,管线末端往里写;当纹理时,片段着色器从里读。切换身份(OpenGL 的 FBO 解绑、Skia 的 makeTemporaryImage())通常不搬运任何数据。
建立这个观念之后,后处理、阴影贴图(第 8 篇那张深度图)、延迟渲染的 G-buffer 就全是同一个机制的不同用法。
注意切换有代价:GPU 要确保写入完成,可能刷缓存、转格式;移动端 tile 架构上尤其贵。
3. 什么是"全屏 pass"?为什么说所有后处理效果共享同一个外壳?
画两个三角形盖满屏幕,让片段着色器对每个屏幕像素跑一次,输入是上一趟的纹理。
外壳永远一样:几何是固定的全屏矩形、没有深度测试、没有光照、几何复杂度为零。
差别全在那段片段着色器里:模糊是采一圈邻居加权平均,色调映射是套一条曲线,锐化是原图加高频,边缘检测是一组和为 0 的权重。
所以看到任何后处理效果,先拆成"外壳 + 一段着色器",只去想着色器在算什么。
4. 一条 6 个效果的后处理链,最少需要几张纹理?为什么?
2 张。
因为每一趟只需要"上一趟的结果",更早的中间结果可以立刻丢弃。读 A 写 B,下一趟读 B 写 A,来回对调——这就是乒乓缓冲。
(例外:有些效果需要同时读多个历史结果,比如 bloom 最后要把各级模糊结果和原图一起合成,那就得多留几张。)
5. bloom 为什么要先降采样?这不是会丢细节吗?
因为"大范围模糊"在全分辨率上做不起。光晕要扩散上百像素,对应的卷积核会大到无法接受。在 1/16 分辨率上用一个小核,等价于全分辨率上一个 16 倍大的核。
丢细节在这里恰好无害——bloom 的目标本来就是一团糊的光晕,高频细节根本不需要。M1 第 7 篇讲过降采样会走样,但也说了:当下游本来就要一张糊图时,走样引入的误差看不出来。
图里 5 级金字塔加起来只有原图的 133% 像素量,比在全分辨率上做两次模糊还便宜。
通用取舍:一个效果如果本来就要丢高频,先降分辨率再做几乎总是划算的。
小结
| 概念 | 一句话 | 要点 |
|---|---|---|
| 为什么要离屏 | 不能边读边写同一块内存 | 正确性问题,不是效率问题 |
| 渲染目标 ↔ 纹理 | 同一块显存的两种身份 | 切换不搬数据,但不免费 |
| FBO | OpenGL 里挂纹理当渲染目标的机制 | Vulkan 对应 image + view + layout |
| 全屏 pass | 两个三角形盖满屏幕 | 所有后处理的公共外壳 |
| 效果的差别 | 只在那段片段着色器里 | 拆成"外壳 + 着色器"来想 |
| 乒乓缓冲 | 读 A 写 B,下一趟对调 | 任意长的链只要 2 张纹理 |
| 可分离卷积 | 横一趟 + 竖一趟 | 次采样降到 次 |
| bloom 降采样 | 让大范围模糊变得可行 | 丢的高频本来就不需要 |
| 色调映射 | HDR 压进 SDR 的曲线 | 线性空间算完之后、编码之前做 |
| MRT / G-buffer | 一次绘制写多张纹理 | 延迟渲染的基础;移动端带宽吃不消 |
延伸阅读
- LearnOpenGL-CN《帧缓冲》:https://learnopengl-cn.github.io/04 Advanced OpenGL/05 Framebuffers/
- LearnOpenGL-CN《Bloom》:https://learnopengl-cn.github.io/05 Advanced Lighting/07 Bloom/
- Jorge Jimenez《Next Generation Post Processing in Call of Duty: Advanced Warfare》(工业界后处理链的经典演讲):https://advances.realtimerendering.com/s2014/index.html
- AOSP 源码:
frameworks/native/libs/renderengine/skia/SkiaRenderEngine.cpp、filters/BlurFilter.cpp
觉得有用?关注公众号「阿豪讲Framework」
Android 系统开发,新文章第一时间推送。