
05. 深度:谁遮住谁
05. 深度:谁遮住谁
本篇位置:模块二 · 第 5 篇 | 前置:纹理 | 预计阅读:30 分钟
你已经在用它了
hwui 处理 View 的 elevation 时,画之前先按 Z 排一次序(libs/hwui/pipeline/skia/ReorderBarrierDrawables.cpp):
void StartReorderBarrierDrawable::onDraw(SkCanvas* canvas) {
    // ...
    std::stable_sort(mChildren.begin(), mChildren.end(),
                     [](RenderNodeDrawable* a, RenderNodeDrawable* b) {
                         const float aZValue = a->getNodeProperties().getZ();
                         const float bZValue = b->getNodeProperties().getZ();
                         return aZValue < bZValue;
                     });
    // 然后按这个顺序依次画
}
排完序从小到大画,Z 大的后画、盖在上面——遮挡关系就对了。
三个问题:
- 你排一次序就解决了遮挡。游戏里几十万个三角形,为什么不也排个序?
- 这里排序的粒度是整个 View。有没有排不出正确顺序的情况?
- SurfaceFlinger 连深度缓冲都没有,凭什么也能画对?
学完你会什么
- 说清你在用的这套办法叫什么、它的前提是什么、什么时候会崩。
- 说清 z-buffer 是怎么把"全局排序"换成"逐像素比大小"的。
- 说清 Early-Z 提前到了哪一步、能省什么,以及哪些写法会让它失效。
- 说清绘制顺序为什么会影响性能,以及 depth pre-pass 在买什么。
- 分清 z-order / elevation 和深度缓冲不是一回事。
1. 你用的这套叫画家算法
先给它一个名字。
从后往前依次画、后画的盖住先画的,这个办法叫画家算法(painter's algorithm)——像画家先铺背景、再画中景、最后画前景。
它的优点是简单到不需要任何额外内存:排个序,按顺序画完就对了。SurfaceFlinger 的图层合成、hwui 的 elevation 排序,用的都是这一套。
它成立的前提有两条,而且很强:
- 每个物体有一个确定的深度——能拿来排序;
- 物体之间不存在"部分在前、部分在后"的关系。
你的场景恰好完全满足:图层是平的,整个图层在同一个 Z 上;View 也是平的。所以问题 3 的答案是——SurfaceFlinger 不需要深度缓冲,是因为它的输入天然满足画家算法的前提。
2. 什么时候它会崩
一旦进入真正的三维,这两条前提立刻不成立。

图左:相互穿插——A 的一头在 B 前面,另一头在 B 后面。你没法说"A 在 B 前"或"B 在 A 前",因为两句都只对了一半。图右:循环遮挡——A 压 B,B 压 C,C 又压 A,三者构成一个环,任何顺序都是错的。
这两种情况在三维场景里遍地都是:一棵树的枝叶互相穿插、一个角色的手臂穿过披风、地面和墙的交界处。它们的共同点是——遮挡关系不是"物体级"的,而是"像素级"的。
同一对物体,在这个像素上是 A 在前,在那个像素上是 B 在前。任何基于物体排序的办法,从原理上就答不了这种问题。
这就是问题 1 的答案:游戏不排序,不是因为几十万个三角形排不动(排序其实不慢),而是因为排序这个思路本身就是错的——存在根本排不出正确顺序的场景。
3. z-buffer:把排序换成逐像素比大小
解法很直接:既然遮挡是像素级的,那就在像素级解决。
给帧缓冲配一块同样大小的深度缓冲(depth buffer,也叫 z-buffer),每个像素存一个数——当前这个位置上,已经画过的最近的东西有多近。
画每个片段时做一次深度测试:
if (这个片段的深度 < 深度缓冲里的值) {
    写入颜色;
    更新深度缓冲;
} else {
    丢弃这个片段;          // 被挡住了
}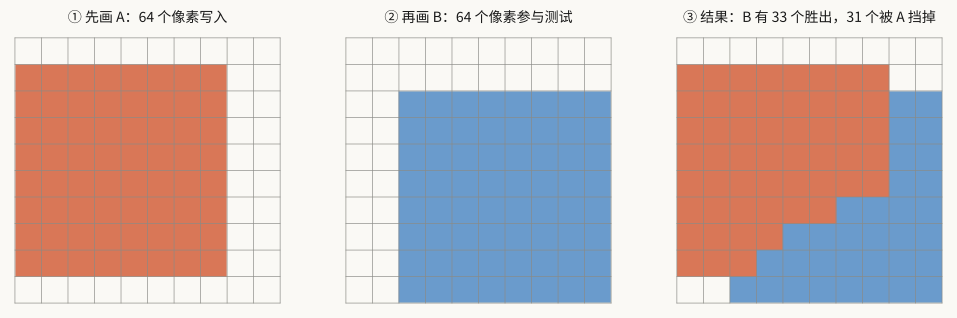
图:先画 A,64 个像素全部写入。再画 B,64 个像素参与深度测试,其中 33 个比 A 更近、胜出,另外 31 个被 A 挡掉、丢弃。注意最终结果里 A 和 B 的分界是一条锯齿状的线——它是逐像素比出来的,不是谁整体压着谁。
这套办法有三个决定性的好处:
- 绘制顺序无关——先画 A 还是先画 B,结果完全一样。穿插、循环遮挡全部自动正确。
- 无需全局信息——每个片段只和深度缓冲里的一个数比较,不需要知道场景里还有什么。
- 天然并行——各像素互不干扰。
代价是一块和屏幕同样大小的额外内存,以及每个片段一次读、可能一次写。在移动端这笔带宽账不小,第 11 篇会算。
深度值不是线性的。深度缓冲里存的不是"距离相机多少米",而是透视投影之后的那个 ,它对真实距离是非线性的——近处精度极高,远处精度急剧下降。这就是 z-fighting(两个共面的东西闪烁)的来源,也是 near 平面不能设太小的原因。
M1 第 5 篇已经把这件事连同那个"让人不舒服的数字"讲透了,这里不重复。只提一句实践结论:调 near 比调 far 有用得多。
4. Early-Z:把测试提到着色之前
上面那段伪代码有个明显的浪费:深度测试写在了片段着色之后。
一个片段跑完整个片段着色器——采了纹理、算了光照——最后被告知"你被挡住了,扔掉"。算白了。
Early-Z(也叫 early depth test)就是把深度测试提到片段着色之前:光栅化生成片段后,先查深度缓冲,挡住了就直接丢,根本不进片段着色器。
这是现代 GPU 默认开启的硬件优化,不需要你做任何事。但有几类写法会让它失效,而且失效是静默的:
| 写法 | 为什么会打破 Early-Z |
|---|---|
片段着色器里写 discard | 着色器可能丢弃片段,深度到底写不写要等着色完才知道 |
片段着色器里改写深度(gl_FragDepth) | 深度值由着色器决定,测试当然得等它算完 |
| 开着混合(blending) | 半透明片段不该更新深度,且它需要读背景色(第 6 篇) |
前两条尤其容易踩:给一个物体加一句 alpha test(if (a < 0.5) discard;),整个 draw call 的 Early-Z 就没了。树叶、栅栏、镂空图案这类用 alpha test 做的东西,在移动端是常见的性能坑——画面上看不出任何异常,只是变慢了。
有个折中办法叫 alpha to coverage:不用
discard,而是把 alpha 转成第 9 篇讲的覆盖率交给 MSAA 处理。这样 Early-Z 保住了,边缘还能有抗锯齿。代价是需要开 MSAA。
5. 绘制顺序:z-buffer 让结果无关,但性能有关
前面说 z-buffer 的好处是"绘制顺序无关"。那是指结果,不是指性能。
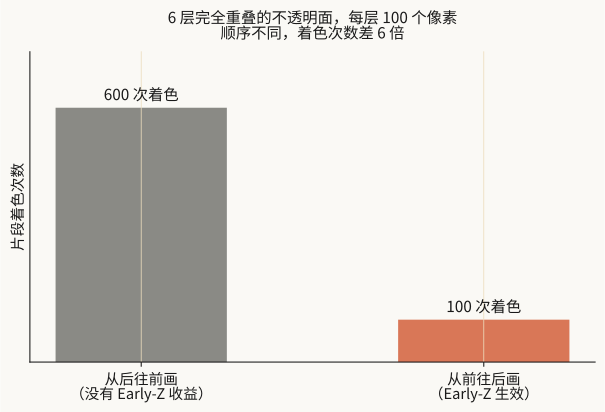
图:6 层完全重叠的不透明面,每层 100 个像素。从后往前画,每一层都通过深度测试、都要着色,共 600 次;从前往后画,第一层写完深度之后,后面 5 层全部被 Early-Z 拦下,共 100 次。差 6 倍。
同一个像素被着色多次,这个现象叫 overdraw(过度绘制)。你对它并不陌生——开发者选项里那个"调试 GPU 过度绘制"的彩色叠加图,量的就是这个。
结论很反直觉但很实用:不透明物体应该从前往后画。这和画家算法的要求正好相反。
原因就是 Early-Z:先画最近的,深度缓冲很快被填上小值,后面远处的片段一测就被拦掉,连着色器都不进。
但半透明物体必须从后往前画——它需要读到背景色才能混合(第 6 篇)。所以真实引擎的绘制顺序是:
- 不透明物体:从前往后(吃 Early-Z 的红利)
- 半透明物体:从后往前(保证混合正确)
6. depth pre-pass:花一趟换一趟
从前往后排序也有成本,而且排序只能到物体级,物体内部还是会有 overdraw。有个更彻底的办法:
先跑一趟只写深度、不算颜色的 pass(关掉颜色写入、用最简单的顶点着色器),把整个场景的深度缓冲填满;然后再跑一趟正式渲染,这时每个像素的深度缓冲里已经是最终的最近值,所有被遮挡的片段在 Early-Z 就被拦掉,片段着色器保证只对可见像素执行一次。
这叫 depth pre-pass(或 Z-prepass)。
它买的是什么?用"多跑一趟几何"换"片段着色器一次不浪费"。
划算的条件是:片段着色器很贵,且 overdraw 严重。复杂光照、多层材质的场景,这笔账通常赚;如果片段着色器本来就很轻(比如你的图层合成,就是采一次纹理),多跑一趟几何反而亏。
移动端的情况又不一样——TBDR 架构自带一种叫 hidden surface removal 的机制,能在硬件层面消掉大部分 overdraw,depth pre-pass 的收益因此小很多,有时反而是净亏。第 11 篇会讲清楚为什么。
⚠️ 别搞混
你熟的 z-order / elevation 和这一篇的深度缓冲,都在管"谁在前面",但完全不是一回事:
| z-order / elevation | 深度缓冲 | |
|---|---|---|
| 粒度 | 整个图层 / 整个 View | 单个像素 |
| 怎么用 | 排序,决定绘制顺序 | 逐像素比大小,决定写不写 |
| 存在哪 | 就是个属性值 | 一块和屏幕同样大的显存 |
| 能处理穿插吗 | 不能 | 能 |
| 能处理循环遮挡吗 | 不能 | 能 |
| 结果依赖绘制顺序吗 | 完全依赖 | 不依赖(但性能依赖) |
| 额外开销 | 一次排序 | 一块显存 + 每片段读写 |
一个是"排队",一个是"逐格投票"。你的世界里所有东西都是平的、能排队,所以排队就够了;三维世界里东西会互相穿插,只能逐格投票。
回到源码
问题 1:游戏为什么不排序?
不是排不动,是这个思路本身答不了三维的遮挡问题。
排序的前提是"任意两个物体之间有确定的前后关系"。相互穿插和循环遮挡这两种情况下,这个前提直接不成立——同一对物体在不同像素上前后关系相反。任何物体级的排序都必然出错。
所以要换个层级:在像素级解决,也就是 z-buffer。
问题 2:hwui 那个排序有排不出来的情况吗?
有,但在它的场景里碰不到。View 是平的、整个 View 在同一个 Z 上,满足画家算法的前提。
真正会出问题的是把 View 做 3D 旋转的时候——rotationX/rotationY 让 View 不再平行于屏幕,理论上就可能和另一个 View 穿插。hwui 的应对是不去解决它(继续按 Z 排序),因为 UI 场景里几乎不会出现真正的穿插。这又是一个"正确性依赖了没写在代码里的前提"的例子。
问题 3:SurfaceFlinger 凭什么不用深度缓冲?
因为它的输入天然满足画家算法:图层是平的、有确定的 Z、不会互相穿插。
这不是简化,是恰当。给合成器加一块深度缓冲,只会白白多出一块和屏幕同样大的显存和每片段的读写带宽,换不来任何正确性。用得着排序就别上 z-buffer——这也是移动端合成器省电的一环。
自测
1. 画家算法失效的两种情况分别是什么?它们的共同点是什么?
相互穿插(A 的一部分在 B 前、另一部分在 B 后)和循环遮挡(A 压 B、B 压 C、C 压 A)。
共同点是:遮挡关系不是物体级的,而是像素级的——同一对物体在不同像素上前后关系不同。
只要遮挡关系是像素级的,任何基于物体排序的方法都必然出错,不管排序算法多聪明。
2. z-buffer 说"绘制顺序无关",但为什么又说不透明物体要从前往后画?
"顺序无关"说的是结果,不是性能。
结果确实与顺序无关——先画谁最后画面都一样。但性能差别很大:从前往后画,最近的物体先填好深度,后面远处的片段在 Early-Z 就被拦掉,不进片段着色器。
图里 6 层完全重叠的例子,从后往前 600 次着色,从前往后只要 100 次,差 6 倍。
注意半透明物体相反,必须从后往前——它要读背景色做混合。
3. 给一个树叶材质加了 if (a < 0.5) discard;,画面没变但帧率掉了。为什么?
打破了 Early-Z。
Early-Z 的前提是"深度测试的结果不依赖片段着色器"。一旦着色器里有 discard,硬件就无法在着色前确定这个片段最终会不会写深度,只能退回到"先着色、后测试"。
于是这个 draw call 里所有被遮挡的片段都要跑完整个着色器才被丢弃。画面完全正确,只是白算了很多——这类性能退化是静默的,看画面发现不了。
同类的还有:写 gl_FragDepth、开混合。折中方案是用 alpha to coverage 代替 discard。
4. depth pre-pass 用什么换什么?什么时候不划算?
用"多跑一趟几何"换"片段着色器一次不浪费"。
先跑一趟只写深度的 pass 填满深度缓冲,第二趟正式渲染时所有被遮挡的片段在 Early-Z 就被拦掉,片段着色器保证只对可见像素执行一次。
不划算的情况有两种:片段着色器本身很轻(比如只采一次纹理,那多跑一趟几何是净亏);或者 overdraw 本来就不严重。
移动端还要额外考虑 TBDR 自带的硬件消隐机制,会让 pre-pass 的收益大打折扣(第 11 篇)。
5. 为什么说给 SurfaceFlinger 加深度缓冲是"纯亏"?
因为它换不来任何正确性。
深度缓冲解决的是"物体级排序解决不了的像素级遮挡"。而 SF 的输入——平的、有确定 Z、不会互相穿插的图层——完全满足画家算法的前提,排序就已经给出了正确答案。
加上深度缓冲只会多出:一块和屏幕同样大的显存,以及每个片段一次深度读、一次深度写的带宽。移动端最缺的恰恰是带宽(第 11 篇)。
用得着排序就别上 z-buffer。
小结
| 概念 | 一句话 | 要点 |
|---|---|---|
| 画家算法 | 排序后从后往前画 | 前提:物体可排序、不穿插 |
| 它什么时候崩 | 相互穿插、循环遮挡 | 遮挡是像素级的,物体级排序答不了 |
| z-buffer | 每像素存一个最近深度,逐片段比 | 顺序无关、无需全局信息、天然并行 |
| 代价 | 一块屏幕大小的显存 + 每片段读写 | 移动端要算这笔带宽账 |
| 深度非线性 | 近处精度高、远处急剧下降 | z-fighting 的来源;调 near 比调 far 有用 |
| Early-Z | 把深度测试提到着色之前 | 默认开启,能省掉被遮挡片段的着色 |
| 什么打破它 | discard、写 gl_FragDepth、混合 | 静默退化,画面看不出来 |
| overdraw | 同一像素被着色多次 | 开发者选项那张彩色图量的就是它 |
| 绘制顺序 | 不透明从前往后,半透明从后往前 | 前者吃 Early-Z,后者保证混合正确 |
| depth pre-pass | 先跑一趟只写深度 | 片段着色器贵 + overdraw 重时才划算 |
延伸阅读
- LearnOpenGL-CN《深度测试》:https://learnopengl-cn.github.io/04 Advanced OpenGL/01 Depth testing/
- ARM Developer《Early-Z 与移动端最佳实践》:https://developer.arm.com/documentation/102540/latest/
- 《A trip through the Graphics Pipeline》Part 9:Z-buffering:https://fgiesen.wordpress.com/2011/07/10/a-trip-through-the-graphics-pipeline-2011-part-9/
- AOSP 源码:
frameworks/base/libs/hwui/pipeline/skia/ReorderBarrierDrawables.cpp
觉得有用?关注公众号「阿豪讲Framework」
Android 系统开发,新文章第一时间推送。