
01. 开篇:buffer 里的像素从哪来
01. 开篇:buffer 里的像素从哪来
本篇位置:模块二 · 第 1 篇 | 前置:模块一 · 图形学数学基础 | 预计阅读:25 分钟
你已经在用它了
SurfaceFlinger 回落 GPU 合成时,最后干活的是这个函数(libs/renderengine/skia/SkiaRenderEngine.cpp,删去了调试与厂商分支):
void SkiaRenderEngine::drawLayersInternal(...) {
    // ...
    for (const auto& layer : layers) {
        // 图层自己的变换,作用到画布矩阵上
        canvas->concat(getSkM44(layer.geometry.positionTransform).asM33());

        const auto [bounds, roundRectClip] =
                getBoundsAndClip(layer.geometry.boundaries, layer.geometry.roundedCornersCrop,
                                 layer.geometry.roundedCornersRadii);
        // ... 建 shader、设 paint ...
        canvas->drawRect(bounds.rect(), paint);
    }

    auto drawFence = sp<Fence>::make(flushAndSubmit(context, dstSurface));
}
这段代码你大概能一行行讲清楚:拿到一串 layer,逐个设好变换和 paint,画进 dstSurface,最后 flush、拿 fence。
三个问题:
flushAndSubmit之后,一张合成好的图就在 buffer 里了。中间 GPU 到底做了什么? 这行代码底下是一整条流水线,它有几站?- 你做的是"把几张图叠起来",游戏做的是"从三维场景算出一张图"。在 GPU 眼里,这是两件不同的事吗?
- 为什么渲染非得分成那么几个固定的阶段? 谁规定的,能不能自己重排?
第 2 个问题是这一篇的枢纽。答案会让你发现:你已经在用这条管线了,只是用的是它最简单的一种情况。
学完你会什么
- 说清一次图层合成在 GPU 里其实走了哪几站,以及它和游戏渲染的关系。
- 说出渲染管线五个阶段的名字和各自的一句话职责。
- 分清哪两站是你写代码的地方,哪三站是硬件固定的、只能调开关。
- 说清一份数据从顶点走到片段中间经过了什么。
- 说清光线追踪是另一条什么样的路,以及游戏为什么没有全面改用它。
1. 你的合成,已经是一次完整的渲染
先把那句 canvas->drawRect(bounds.rect(), paint) 拆开。
GPU 不认识"矩形",它只认三角形。所以这行代码交给驱动之后,第一件事就是把矩形拆成两个三角形——四个角变成四个顶点,每个顶点除了位置,还带着一个纹理坐标(UV),标明"这个角对应贴图上的哪个位置"。
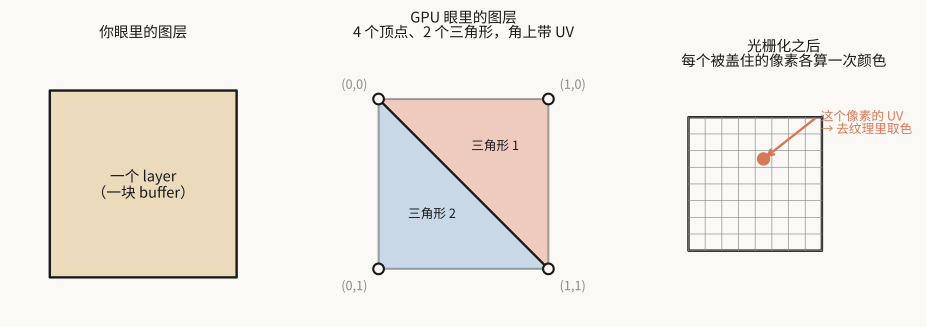
图左:你眼里的图层,一块 buffer。图中:GPU 眼里的图层——4 个顶点、2 个三角形,每个角带一份 UV。图右:光栅化之后,每个被盖住的像素各算一次颜色,颜色来自按 UV 去纹理里采样。
对照一下你写过的每一行:
| 你的代码 | 管线里是什么 |
|---|---|
canvas->concat(positionTransform) | 顶点变换——把这 4 个顶点搬到屏幕上该在的位置 |
canvas->drawRect(bounds.rect(), ...) | 图元装配 + 光栅化——2 个三角形,判定盖住了哪些像素 |
paint.setShader(image->makeShader(...)) | 片段着色——每个像素按 UV 去纹理里取色 |
| 图层之间的叠加 | 输出合并——混合 |
所以问题 2 的答案是:在 GPU 眼里,这就是同一件事。
你的合成和游戏渲染走的是同一条管线,区别只在于你喂给它的东西特别简单:
| 你的合成 | 游戏的一帧 | |
|---|---|---|
| 三角形数量 | 每个图层 2 个,一共几十个 | 几十万到几百万个 |
| 顶点变换 | 一个 2D 的 3×3 矩阵 | MVP 三次换坐标系(M1 第 4 篇) |
| 片段着色器在干什么 | 采一次纹理,乘个 alpha | 采好几张纹理、算光照、算阴影 |
| 深度 | 没有,靠图层顺序 | z-buffer 逐像素比 |
| 输出 | 一张图 | 好几张中间图,再后处理 |
这本书要讲的,就是把右边这一列填满。你已经站在管线上了,只是一直站在它最浅的那一头。
2. 管线的五站
无论 GLES 还是 Vulkan,无论合成还是游戏,数据都按这个固定顺序走:
两端的"顶点数据"和"帧缓冲"是容器,真正干活的是中间五站:
① 顶点处理(Vertex Shader)——对每个顶点跑一遍同一段代码。主要工作是把顶点搬到屏幕上该在的位置(你那行 concat 干的事,游戏里是 MVP 变换),顺便把 UV、法线这些数据算好传给下游。
② 图元装配(Primitive Assembly)——把顶点按三个一组拼成三角形,并把完全看不见的丢掉(视锥外的整个扔掉,跨边界的切开)。
③ 光栅化(Rasterization)——判定每个三角形盖住了哪些像素,为每个被盖住的像素生成一个片段(fragment),同时把顶点上的 UV、法线插值到每个片段上。
④ 片段处理(Fragment Shader)——对每个片段跑一遍代码,采样纹理、算光照,决定这个片段是什么颜色。
⑤ 输出合并(Output Merging)——深度测试(谁遮住谁)、混合(半透明怎么叠),写进帧缓冲。
这个顺序不能改,也不能跳。任何一次绘制都得从头走到尾。
"片段"和"像素"有什么区别?片段是"某个三角形在这个位置的一份候选结果"。同一个像素位置可能收到好几个片段(几个三角形都盖到了它),最后谁能写进帧缓冲,由第 ⑤ 站决定。像素是屏幕上的格子,片段是竞争这个格子的候选人。
3. 谁可编程、谁固定
图里刻意把 ① ④ 标成了主色,因为只有这两站是你写代码的地方:
| 阶段 | 可编程性 | 你能调什么 |
|---|---|---|
| 顶点处理 | 可编程 | 整段 shader 代码由你写 |
| 图元装配 | 固定功能 | 图元类型(三角形/线/点)、面剔除方向 |
| 光栅化 | 固定功能 | 多重采样数、填充模式 |
| 片段处理 | 可编程 | 整段 shader 代码由你写 |
| 输出合并 | 固定功能 | 深度测试开关与比较函数、混合方程 |
"固定功能"说的是算法不可改,不是完全不可配。光栅化怎么判定覆盖是硬件写死的,但你能决定开不开 MSAA、采几个点(第 9 篇);混合怎么算是硬件写死的,但你能决定用哪个方程(第 6 篇)。
这回答了问题 3 的一半:这五站的顺序不是谁拍脑袋定的,是因为它们之间有严格的数据依赖——不知道三角形盖住哪些像素(③),就没法逐像素算颜色(④);不知道颜色(④),就没法决定要不要写进去(⑤)。顺序是被依赖关系逼出来的。
至于为什么中间三站要做成固定硬件:因为它们要做的事极其规整且量大。光栅化对每个像素做的判断完全一样,做成专用电路能比通用计算快一到两个数量级。能通用的地方留给你写 shader,能专用的地方交给硬件——这就是整条管线的设计取舍。
4. 数据是怎么流过去的
除了"每站做什么",还有一条容易被忽略的线:数据本身怎么走。
顶点缓冲里存的是顶点属性(vertex attributes)——位置、UV、法线、颜色。顶点着色器读到它们,算出屏幕位置,同时可以额外输出任意多份数据给下游。这些额外输出的数据有个专门的名字:varying(现代写法是顶点着色器的 out 变量 / 片段着色器的 in 变量)。
关键在光栅化这一步。一个三角形只有 3 个顶点,各带一份 varying;而它内部可能盖住几千个像素,每个像素都需要一份属于自己的值。光栅化负责把 3 份插成几千份:
这个插值用的正是 M1 第 6 篇讲过的重心坐标——三个顶点按面积占比加权。而且必须做透视校正(先除以 再插值),否则近大远小会让插值结果在三维空间里扭曲。
"varying" 这个名字说的就是这件事:一份逐片段变化的数据。
具体怎么算留给第 3 篇。这里只要记住这条链——它是"三角形怎么变成一片颜色正确的像素"的骨架。
5. 另一条路:光线追踪
上面这一整套叫光栅化(rasterization)。它不是唯一的画法。
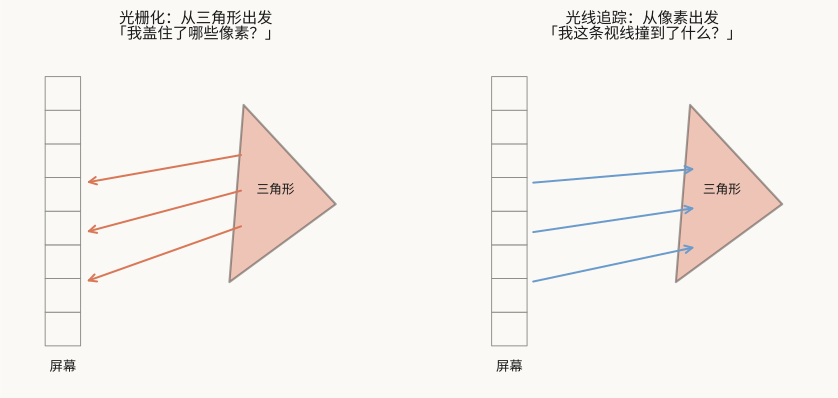
图:两者的箭头方向正好相反。光栅化从三角形出发,问"我盖住了哪些像素";光线追踪从像素出发,问"我这条视线撞到了什么"。
光线追踪(ray tracing)的好处是它天然能算出光栅化很难算的东西:反射里映出的是真实场景、阴影边缘是软的、间接光照自然存在——因为它就是在模拟光线本身怎么走。
那游戏为什么没全面改用它?
因为两者的复杂度完全不同。光栅化里,一个三角形盖住哪些像素,是一道局部的题——只看这一个三角形。光线追踪里,一条光线撞到什么,要和整个场景比对;而且一条光线撞到物体之后往往还要再发射新的光线(反射、折射、阴影探测),代价指数级往上走。
今天的做法是混着用:主体仍然光栅化,只在最需要的地方(反射、阴影)打少量光线,再靠降噪把稀疏的结果补成完整画面。这也是移动端目前极少用它的原因——功耗预算撑不住。
这本书讲的全部是光栅化这条路。知道另一条路存在、知道它凭什么更真实、也知道它贵在哪,就够了。
6. 这本书的地图
后面每一篇都在讲这条管线上的某一站,或者站与站之间的东西:
| 篇 | 讲什么 | 在管线的哪一站 |
|---|---|---|
| 2 顶点 | 顶点着色器在干嘛、图元装配、裁剪、剔除 | ① ② |
| 3 光栅化 | 怎么判定覆盖、怎么插值出片段 | ③ |
| 4 纹理 | 片段怎么去贴图里取色 | ④ |
| 5 深度 | 谁遮住谁 | ⑤ |
| 6 混合 | 半透明怎么叠 | ⑤ |
| 7 光照 | 颜色怎么算出来 | ④ |
| 8 阴影 | 影子怎么来的 | 要跑两遍 ①~⑤ |
| 9 抗锯齿 | 为什么边缘是毛的 | ③ 与画完之后 |
| 10 帧缓冲与后处理 | 画到别处再加工 | 帧缓冲,以及再跑一遍管线 |
| 11 手机 GPU | 为什么手机的 GPU 长这样 | 整条管线的硬件实现 |
卡住的时候,回来看这张表,先定位"我现在在哪一站",往往比继续往下读更有用。
回到源码
问题 1:flushAndSubmit 底下 GPU 做了什么?
对每个 layer:4 个顶点被变换到屏幕位置(①)、拼成 2 个三角形并裁掉屏幕外的部分(②)、判定盖住了哪些像素并把 UV 插值到每个像素上(③)、每个像素按 UV 采一次纹理、乘上 alpha(④)、和已经画好的内容混合后写进 dstSurface(⑤)。
flushAndSubmit 本身只是"把攒着的命令真正提交给 GPU"——上面那些是 GPU 收到命令之后才发生的。
问题 2:合成和游戏渲染是两件事吗?
是同一件事。同一条管线、同一个顺序。区别只在于喂进去的复杂度:你喂几十个三角形、一个 2D 变换、一次纹理采样、没有深度;游戏喂几十万个三角形、三次坐标系变换、多张纹理加光照加阴影、逐像素深度测试。
你不是要学一门新技术,你是要把已经在用的这条管线用深。
问题 3:为什么阶段是固定的?
因为存在硬性的数据依赖——不知道覆盖哪些像素就没法算颜色,不知道颜色就没法决定写不写。顺序是被依赖关系逼出来的,不是约定。
中间三站做成固定硬件,是因为它们的工作极其规整且量大,专用电路比通用计算快一到两个数量级。可编程留给需要灵活的地方,固定功能留给需要快的地方。
自测
1. 一次 canvas->drawRect() 交给 GPU 之后,那个矩形变成了什么?
两个三角形,一共 4 个顶点。
GPU 的光栅化硬件只处理三角形——它是能确定一个平面的最简单图元,且任意多边形都能拆成三角形。矩形、圆角矩形、路径,最终都会被拆成三角形(圆角那段弧会被拆成很多个细长三角形)。
每个顶点除了位置,还带着 UV,用来在片段阶段去纹理里取色。
2. 片段(fragment)和像素(pixel)有什么区别?
像素是屏幕上的格子,片段是竞争这个格子的候选人。
光栅化时,每个三角形对它盖住的每个位置生成一个片段。如果三个三角形都盖住了同一个位置,这个位置就会产生 3 个片段。
它们各自跑一遍片段着色器算出颜色,最后由输出合并阶段(深度测试、混合)决定谁写进帧缓冲、怎么写。"一个像素只被着色一次"这件事并不成立——这正是第 5 篇 overdraw 问题的根源。
3. 管线五站里,哪些是你写 shader 的地方?剩下的完全不能控制吗?
顶点处理和片段处理这两站是可编程的,整段代码由你写。
图元装配、光栅化、输出合并是固定功能——算法不可改,但都有配置开关:图元类型和剔除方向、多重采样数、深度测试的比较函数、混合方程。
"固定功能"说的是"你改不了它怎么算",不是"你什么都决定不了"。
4. varying 是什么?为什么需要它?
顶点着色器输出、片段着色器输入的那批数据(UV、法线、顶点色等)。
需要它是因为:一个三角形只有 3 个顶点,但内部可能盖住几千个像素。光栅化负责把 3 份数据用重心坐标插成几千份,让每个片段都拿到一份属于自己的值。
"varying" 这个名字描述的就是"逐片段变化"这件事。透视投影下插值还必须做透视校正(先除 再插),否则三维空间里的比例关系会错。
5. 光线追踪画面更真实,为什么手机游戏基本不用?
因为复杂度的性质不同。
光栅化里"一个三角形盖住哪些像素"是局部问题,只看这一个三角形,非常适合做成并行的专用电路。光线追踪里"一条光线撞到什么"要和整个场景比对,而且撞上之后往往还要再发射新光线(反射、折射、阴影探测),代价指数级增长。
今天主流是混合方案:主体光栅化,只在反射、阴影这些光栅化最吃力的地方打少量光线再降噪。移动端连这个都很少用——功耗预算撑不住(第 11 篇会讲手机上真正稀缺的是什么)。
小结
| 概念 | 一句话 | 要点 |
|---|---|---|
| 合成 vs 渲染 | 同一条管线,复杂度不同 | 你已经在用它,只是用得浅 |
| GPU 只认三角形 | 矩形 = 2 个三角形 | 圆角、路径都会被拆成三角形 |
| 五站 | 顶点→装配→光栅化→片段→输出合并 | 顺序被数据依赖逼出来,不能跳 |
| 可编程的两站 | 顶点处理、片段处理 | 其余三站算法固定、参数可配 |
| 片段 ≠ 像素 | 片段是候选人,像素是格子 | 一个像素可能收到多个片段 |
| varying | 逐片段变化的数据 | 顶点输出 → 插值 → 片段输入 |
| 透视校正插值 | 先除 再插值 | 否则三维比例会错(M1 第 6 篇) |
| 光线追踪 | 从像素出发找物体 | 更真实,但复杂度性质完全不同 |
延伸阅读
- LearnOpenGL-CN《你好,三角形》(管线各阶段的图文入门):https://learnopengl-cn.github.io/01 Getting started/04 Hello Triangle/
- GAMES101 Lecture 5:Rasterization 1:https://games-cn.org/intro-graphics/
- 《A trip through the Graphics Pipeline》(硬件视角的管线长文,经典):https://fgiesen.wordpress.com/2011/07/09/a-trip-through-the-graphics-pipeline-2011-index/
- AOSP 源码:
frameworks/native/libs/renderengine/skia/SkiaRenderEngine.cpp
觉得有用?关注公众号「阿豪讲Framework」
Android 系统开发,新文章第一时间推送。